- ホーム
- Microsoft
- DP-100 - Designing and Implementing a Data Science Solution on Azure
- Microsoft.DP-100.v2026-05-04.q510
- 質問310
有効的なDP-100問題集はJPNTest.com提供され、DP-100試験に合格することに役に立ちます!JPNTest.comは今最新DP-100試験問題集を提供します。JPNTest.com DP-100試験問題集はもう更新されました。ここでDP-100問題集のテストエンジンを手に入れます。
DP-100問題集最新版のアクセス
「528問、30% ディスカウント、特別な割引コード:JPNshiken」
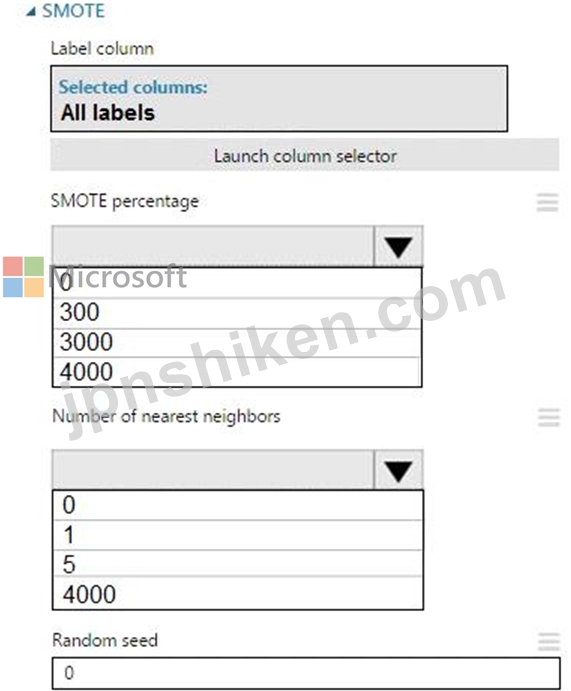
Azure Machine Learning Studio で実験を作成します。10,000 行を含むトレーニング データセットを追加します。最初の 9,000 行はクラス 0 (90%) を表します。
残りの 1,000 行はクラス 1 (10%) を表します。
トレーニングセットは2つのクラス間の不均衡です。5行のデータを使用して、クラス1のトレーニング例の数を4,000に増やす必要があります。実験にSynthetic Minority Oversampling Technique(SMOTE)モジュールを追加します。
モジュールを設定する必要があります。
どの値を使用する必要がありますか? 回答するには、回答領域のダイアログ ボックスで適切なオプションを選択します。
注意: 正しい選択ごとに 1 ポイントが加算されます。
残りの 1,000 行はクラス 1 (10%) を表します。
トレーニングセットは2つのクラス間の不均衡です。5行のデータを使用して、クラス1のトレーニング例の数を4,000に増やす必要があります。実験にSynthetic Minority Oversampling Technique(SMOTE)モジュールを追加します。
モジュールを設定する必要があります。
どの値を使用する必要がありますか? 回答するには、回答領域のダイアログ ボックスで適切なオプションを選択します。
注意: 正しい選択ごとに 1 ポイントが加算されます。
正解:
Explanation:
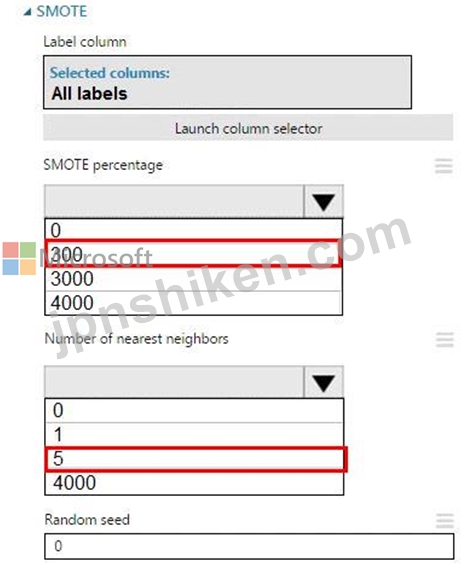
ボックス1: 300
300 (%) と入力すると、モジュールは元のデータセット (1000) と比較して少数事例の割合 (3000) を 3 倍にします。
ボックス2: 5
5 つのデータ行を使用する必要があります。
「最近傍点の数」オプションを使用して、SMOTEアルゴリズムが新しいケースを構築する際に使用する特徴空間のサイズを決定します。最近傍点とは、あるターゲットケースに非常に類似したデータ行(ケース)です。任意の2つのケース間の距離は、すべての特徴量の重み付きベクトルを組み合わせることで測定されます。
最近傍の数を増やすと、より多くのケースから特徴を取得できます。
最近傍点の数を少なくすることで、元のサンプルに似た特徴をより多く使用します。
参考文献:
https://docs.microsoft.com/en-us/azure/machine-learning/studio-module-reference/smote

- 質問一覧「510問」
- 質問1 コンピューティング クラスターを使用して新しい Azure Machine ...
- 質問2 Azure Machine Learning を使用してモデルをトレーニングします...
- 質問3 Azure Machine Learning ワークスペースを作成します。表形式の...
- 質問4 自動機械学習を用いて回帰モデルを学習させる予定です。欠損値を
- 質問5 同僚が次のコードを使用して、機械学習サービス ワークスペース
- 質問6 Azure Machine Learning ワークスペースを作成します。 プライベ...
- 質問7 糖尿病検査を受けた患者の記録を含むデータセットがあります。デ
- 質問8 Azure Machine Learning を使用してモデルをトレーニングします...
- 質問9 Azure Machine Learning ワークスペースを管理しています。Azure...
- 質問10 Azure Machine Learning ワークスペースには、real_estate_data ...
- 質問11 機械学習モデルを開発しています。 テストのために機械学習モデ
- 質問12 Azure Machine Learning Studio で分類タスクを実行しています。...
- 質問13 Azure Machine Learning ワークスペースを作成します。Azure Mac...
- 質問14 Python SDK v2を使用して、Azure Machine Learningワークスペー...
- 質問15 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
- 質問16 スペースを確保し、開発環境を構築します。Tensorflowフレームワ...
- 質問17 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
- 質問18 Azure Machine Learningワークスペースを管理しています。Azure ...
- 質問19 外れ値を削除する前に、年齢列に外れ値が存在するかどうかを視覚
- 質問20 Azure Al Foundry プロジェクトのフローを開発します。 フローを...
- 質問21 データセットに対して特徴エンジニアリングを実行しています。 C...
- 質問22 Azure Container Instances にモデルをデプロイします。 モデル ...
- 質問23 Azure Machine Learning Studio で多重線形回帰モデルを作成して...
- 質問24 Azure Machine Learning SDK for Python を使用して 2 段階のパ...
- 質問25 機械学習モデルを作成しています。null行を含むデータセットがあ...
- 質問26 分類タスクに取り組んでいます。ある生徒がサッカーをしたいかど
- 質問27 完成したバイナリ分類機械学習モデルを評価しています。 評価基
- 質問28 (Exhibit) 以下の各記述について、正しい場合は「はい」を選択し...
- 質問29 ML-workspace という名前の Azure Machine Learning ワークスペ...
- 質問30 データの視覚化要件に従って、診断テスト評価用の視覚化を作成す
- 質問31 ホットスポットに関する質問 Azure Machine Learning ワークスペ...
- 質問32 CSVファイルからテキストを前処理する予定です。Azure Machine L...
- 質問33 Azure Machine Learning を使用して、モデルをリアルタイム Web ...
- 質問34 次の Azure サブスクリプションと Azure Machine Learning サー...
- 質問35 Azure Machine Learning の Hyperdrive 機能を使用してモデルを...
- 質問36 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
- 質問37 Python scnpts を含む 2 つのステップを持つ、パイプライン 1 と...
- 質問38 C-サポートベクター分類を使用して、アンバランスなトレーニング...
- 質問39 以前に、CSV ファイルのフォルダーに基づく training-dataset と...
- 質問40 Azure Machine Learning サービスを使用して、training.data と...
- 質問41 Azure Machine Learning でスクリプトを実験として実行するには...
- 質問42 Azure Machine Learning Service を使用して、ニューラル ネット...
- 質問43 統計分布の非対称性を分析しています。 次の画像には、2 つのデ...
- 質問44 Azure Machine Learningワークスペースを作成し、srcサブフォル...
- 質問45 Azure Machine Learning のリモート コンピューティングでトレー...
- 質問46 アルゴリズムのハイパーパラメータを調整しています。次の表は、
- 質問47 同僚が次のコードを使用して、機械学習サービス ワークスペース
- 質問48 Python SDK v2 を使用して Azure Machine Learning ソリューショ...
- 質問49 Azure Machine Learning Studio で多重線形回帰モデルを作成して...
- 質問50 Azure Machine Learning ワークスペースの所有者です。 カスタム...
- 質問51 Azure Machine Learning サービスで機械学習モデルをトレーニン...
- 質問52 ペナルティ イベント検出のプロセスを定義する必要があります。 ...
- 質問53 Python SDK v2 を使用して Azure Machine Learning ワークスペー...
- 質問54 computet という名前のコンピューティング インスタンスを使用し...
- 質問55 地元のタクシー会社の履歴データを含むデータセットを分析し、回
- 質問56 Azure Machine Learning Studio を使用してデータセットを分析し...
- 質問57 企業向けのデータ エンジニアリング ソリューションを設計します...
- 質問58 Azure Machine Learning ワークスペースを使用しています。モデ...
- 質問59 あなたはワイナリーにデータサイエンティストとして採用されまし
- 質問60 ワークスペースという名前のAzure Machine Learningワークスペー...
- 質問61 Azure Machine Learning ワークスペースを管理しています。Azure...
- 質問62 ドラッグアンドドロップの質問 Azure Machine Learning ワークス...
- 質問63 ホットスポットに関する質問 正確かどうかを確認するには、下線
- 質問64 Azure Machine Learning デザイナーを使用してトレーニング パイ...
- 質問65 ペナルティ イベント検出のプロセスを定義する必要があります。 ...
- 質問66 ローカル ペナルティ検出データに対してスケーリング戦略を実装
- 質問67 機械学習モデルが、敏感な特徴にわたって不公平な予測を生成する
- 質問68 ローカル モデルの特徴抽出戦略を構築する必要があります。 コー...
- 質問69 分類タスクを解決しています。 データセットのバランスが崩れて
- 質問70 データセットに対して特徴エンジニアリングを実行しています。 C...
- 質問71 人が病気にかかっているかどうかを予測するためのバイナリ分類モ
- 質問72 Python SDK v2 を使用して、workspace1 という名前の Azure Mach...
- 質問73 あなたは、画像分類用のディープ畳み込みニューラル ネットワー
- 質問74 Azure Machine Learning Python SDK を使用して、バッチ推論パイ...
- 質問75 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
- 質問76 実験の要件とデータセットに基づいて、特徴ベースの特徴選択モジ
- 質問77 自動車の価格データを含むAzure Machine Learningデータセットを...
- 質問78 Azure Machine Learning ワークスペースを管理しています。model...
- 質問79 アルゴリズムのハイパーパラメータを調整しています。次の表は、
- 質問80 決定木アルゴリズムを使用して分類モデルをトレーニングします。
- 質問81 提供されたトレーニング セットを使用してバイナリ分類モデルを
- 質問82 ペナルティ イベント検出のプロセスを定義する必要があります。 ...
- 質問83 Azure Machine Learning Studio で多重線形回帰モデルを作成して...
- 質問84 パフォーマンス曲線の図に示されているように、広告応答モデルに
- 質問85 近くの気象観測所からデータを収集しています。weather_dfという...
- 質問86 2 クラス ロジスティック回帰モデルを使用してバイナリ分類を作...
- 質問87 同僚が次のコードを使用して、機械学習サービス ワークスペース
- 質問88 Pythonで機械学習モデルを作成しています。提供されたデータセッ...
- 質問89 Azure Machine Learning ワークスペースを管理しています。Azure...
- 質問90 次の Azure サブスクリプションと Azure Machine Learning サー...
- 質問91 あなたはホテル予約ウェブサイト運営会社で働くデータサイエンテ
- 質問92 Azure Machine Learning ワークスペースを使用しています。モデ...
- 質問93 次のコードを使用して、モデルを Azure Machine Learning リアル...
- 質問94 Azure Machine Learning を使用して、モデルをリアルタイム Web ...
- 質問95 fsi という名前のファイル システムと folder1 という名前のフォ...
- 質問96 Azure Machine Learning ワークスペースを作成し、開発環境をセ...
- 質問97 バイナリ分類を実行するためにリカレント ニューラル ネットワー...
- 質問98 参加者に Docker for Windows を紹介する実践的なワークショップ...
- 質問99 モデルのトレーニング要件に応じて早期停止基準を実装する必要が
- 質問100 ノートブックからモデルトレーニングのハイパーパラメータ調整を
- 質問101 Azure Machine Learning ワークスペースで自動機械学習実験を実...
- 質問102 次の形式の salesData という名前の Python データ フレームがあ...
- 質問103 広告応答のモデリング戦略を定義する必要があります。 順番に実
- 質問104 モデルのトレーニング要件に応じて、順列特徴重要度モジュールを
- 質問105 x.1、x2、x3 機能に対して scikit-learn Python ライブラリを使...
- 質問106 Azure Machine Learning デザイナーでトレーニング パイプライン...
- 質問107 Azure ML SDK を使用して実験を実行する準備をしており、コンピ...
- 質問108 Azure Machine Learning ワークスペースを作成します。表形式の...
- 質問109 次のように定義された 6 つのデータ ポイントを含む Python NumP...
- 質問110 Azure Machine Learning Python SDK v2 を使用して自動機械学習...
- 質問111 銀行会社向けに、クレジットカード詐欺の可能性のある事例を特定
- 質問112 グローバル ペナルティ検出モデルのサンプリング戦略を構築する
- 質問113 スペースを確保し、開発環境を構築します。Tensorflowフレームワ...
- 質問114 一連のCSVファイルには売上記録が含まれています。すべてのCSVフ...
- 質問115 Azure Machine Learning ワークスペースを作成します。Azure Mac...
- 質問116 Azure Machine Learning を使用して機械学習モデルを作成します...
- 質問117 統計分布の非対称性を分析しています。 次の画像には、2 つのデ...
- 質問118 新しい Azure サブスクリプションを作成します。サブスクリプシ...
- 質問119 あなたのチームは、データ エンジニアリングとデータ サイエンス...
- 質問120 実験の要件とデータセットに基づいて、特徴ベースの特徴選択モジ
- 質問121 Azure OpenAI サービス モデルが接続された Azure AI Foundry プ...
- 質問122 (Exhibit) 以下の各記述について、正しい場合は「はい」を選択し...
- 質問123 テスト要件に応じてデータを分割する方法を特定する必要がありま
- 質問124 Git リポジトリを使用して、Azure Machine Learning ワークスペ...
- 質問125 Azure Machine Learning ワークスペースでスクリプトのソース管...
- 質問126 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
- 質問127 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
- 質問128 モデルのトレーニング時に選択されたハイパーパラメータを最適化
- 質問129 ノートブックからモデルをトレーニングするためのハイパーパラメ
- 質問130 train.py というPythonスクリプトを作成し、scriptsというフォル...
- 質問131 バイアスと分散の問題に対処するには、グローバル ペナルティ イ...
- 質問132 Azure Machine Learning を使用してモデルをトレーニングします...
- 質問133 あなたはワイナリーにデータサイエンティストとして採用されまし
- 質問134 ある人が病気にかかっているかどうかを予測するための二値分類モ
- 質問135 ローカルワークステーションでAzure Machine Learning SDKを使用...
- 質問136 ホットスポットに関する質問 Azure Machine Learning を使用して...
- 質問137 Azure Machine Learning ワークスペースを管理しています。CSV ...
- 質問138 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
- 質問139 ホットスポットに関する質問 Azure Machine Learning ワークスペ...
- 質問140 人が病気にかかっているかどうかを予測するためのバイナリ分類モ
- 質問141 ローカルワークステーションでAzure Machine Learning SDKを使用...
- 質問142 ローカル ペナルティ検出データに対してスケーリング戦略を実装
- 質問143 Azure Machine Learning Studio で分類タスクを実行しています。...
- 質問144 機械学習モデルを使用してインテリジェントなソリューションを構
- 質問145 Azure Machine Learning ワークスペースを管理しています。既存...
- 質問146 デザイナーを使用して新しい Azure Machine Learning パイプライ...
- 質問147 Azure Machine Learning ワークスペースで自動機械学習実験を実...
- 質問148 大規模な糖尿病患者グループの年齢情報を含むデータセットを分析
- 質問149 ある組織は Azure Machine Learning サービスを使用しており、機...
- 質問150 自動化された機械学習を使用して、分類モデルと回帰モデルをトレ
- 質問151 Azure Machine Learning デザイナーを使用して実験を構築してい...
- 質問152 ホットスポットに関する質問 近くの気象観測所からデータを収集
- 質問153 AccessibilityToHighway 列の欠落データを置き換える必要があり...
- 質問154 参加者に Docker for Windows を紹介する実践的なワークショップ...
- 質問155 あなたは、画像分類用のディープ畳み込みニューラル ネットワー
- 質問156 Azure Machine Learning デザイナーを使用して実験を構築してい...
- 質問157 Azure Machine Learning を使用して機械学習モデルをトレーニン...
- 質問158 ワークスペース内のデータや実験を操作するには、Azure Machine ...
- 質問159 財務チームから、finance-data という名前の Azure Storage BLOB...
- 質問160 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
- 質問161 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
- 質問162 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
- 質問163 Azure Machine Learning Studio で線形回帰モデルを開発していま...
- 質問164 マルチクラス画像分類ディープラーニング モデルを作成します。 ...
- 質問165 Azure Container Instances にモデルをデプロイします。 モデル ...
- 質問166 Azure ML SDK を使用して実験を実行する準備をしており、コンピ...
- 質問167 Azure Machine Learning Studio で分類タスクを実行しています。...
- 質問168 Azure ML SDK を使用して実験を実行する準備をしており、コンピ...
- 質問169 ビジネス アプリケーションで使用されるバッチ推論パイプライン
- 質問170 特徴抽出方法を選択する必要があります。 どちらの方法を使用す
- 質問171 Azure Machine Learning ワークスペースがあり、ローカルコンピ...
- 質問172 2 クラス ロジスティック回帰モデルを使用してバイナリ分類を作...
- 質問173 ワークスペースという名前のAzure Machine Learningワークスペー...
- 質問174 Azure Container Instances にモデルをデプロイします。 モデル ...
- 質問175 ローカル モデルの特徴抽出戦略を構築する必要があります。 コー...
- 質問176 Azure Machine Learning ワークスペースを使用しています。モデ...
- 質問177 次のコードを使用して、モデルを Azure Machine Learning リアル...
- 質問178 モデルの適合の問題を修正する必要があります。 順番に実行する
- 質問179 モデルのトレーニング要件に応じて早期停止基準を実装する必要が
- 質問180 Azure Machine Learning SDK for Python を使用して 2 段階のパ...
- 質問181 マルチクラス画像分類ディープラーニング モデルを作成します。 ...
- 質問182 ホットスポットに関する質問 10,000 個のデータ ポイントと 150 ...
- 質問183 Azure Machine Learning を使用してモデルをトレーニングします...
- 質問184 Azure Machine Learning ワークスペースを作成します。Azure Mac...
- 質問185 Azure Machine Learning Studio で線形回帰モデルを開発していま...
- 質問186 分類タスクに取り組んでいます。ある生徒がサッカーをしたいかど
- 質問187 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
- 質問188 トレーニング クラスターと推論クラスターを含む Azure Machine ...
- 質問189 グローバル ペナルティ検出モデルのサンプリング戦略を構築する
- 質問190 Azure Machine Learning ワークスペースを作成します。Azure Mac...
- 質問191 クリーニングが必要な生のデータセットを分析しています。 Azure...
- 質問192 次の Azure サブスクリプションと Azure Machine Learning サー...
- 質問193 Azure Machine Learning を使用して、Bandit 早期終了ポリシーに...
- 質問194 Azure Machine Learning ワークスペースを作成します。 DataDrif...
- 質問195 アルゴリズムのハイパーパラメータを調整しています。次の表は、
- 質問196 提供されたトレーニング セットを使用してバイナリ分類モデルを
- 質問197 決定木アルゴリズムを使用しています。木の深さが10で適切に一般...
- 質問198 畳み込みニューラルネットワークモデルを複数のエポックにわたっ
- 質問199 Azure Machine Learning Studio で線形回帰モデルを開発していま...
- 質問200 Azure Machine Learning Studio で時系列データセットを使用して...
- 質問201 クラスAとクラスBの100個のサンプルを含むデータセットを使用し...
- 質問202 Azure Machine Learning を使用して機械学習モデルをトレーニン...
- 質問203 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
- 質問204 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
- 質問205 モデルのトレーニング要件に応じて早期停止基準を実装する必要が
- 質問206 Azure Machine Learning のマネージド コンピューティング リソ...
- 質問207 Azure Machine Learning ワークスペースがあります。 次のコード...
- 質問208 ディープ ラーニング仮想マシン (DLVM) を使用して、Compute Uni...
- 質問209 新しい Azure サブスクリプションを作成します。サブスクリプシ...
- 質問210 半構造化、非構造化、構造化データの種類を分析するためのディー
- 質問211 CSVファイルからテキストを前処理する予定です。Azure Machine L...
- 質問212 あなたは、鳥類の健康と渡りを追跡するプロジェクトのリードデー
- 質問213 Python SDK v2 を使用して Azure Machine Learning ワークスペー...
- 質問214 STANDARD_D1 仮想マシン イメージを使用して、ComputeOne という...
- 質問215 Azure Machine Learning Studio で多重線形回帰モデルを作成して...
- 質問216 Azureを使用して機械学習の実験を開発しています。次の画像は、...
- 質問217 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
- 質問218 モデルのトレーニング要件に応じて、順列特徴重要度モジュールを
- 質問219 トレーニング クラスターと推論クラスターを含む Azure Machine ...
- 質問220 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
- 質問221 2 クラス ロジスティック回帰モデルを使用してバイナリ分類を作...
- 質問222 Azure Machine Learning SDK for Python を使用して 2 段階のパ...
- 質問223 トラフィックの最適化のための Azure Machine Learning ソリュー...
- 質問224 Azure Machine Learning Studio を使用して、2 つのデータ セッ...
- 質問225 あなたは、画像分類用のディープ畳み込みニューラル ネットワー
- 質問226 あなたは線形回帰モデルを作成するデータ サイエンティストです
- 質問227 Azure Machine LearningワークスペースでApache Sparkを用いたイ...
- 質問228 Azure Machine Learning SDK v2 for Python とノートブックを使...
- 質問229 Azure Machine Learning ワークスペースのノートブックからパン...
- 質問230 大規模な糖尿病患者グループの年齢情報を含むデータセットを分析
- 質問231 Azure Machine Learning ワークスペースを使用します。 次の Pyt...
- 質問232 ローカル ペナルティ検出データに対してスケーリング戦略を実装
- 質問233 Azure Machine Learningワークスペースを作成し、srcサブフォル...
- 質問234 統計分布の非対称性を分析しています。 次の画像には、2 つのデ...
- 質問235 STANDARD_D1 仮想マシン イメージを使用して、ComputeOne という...
- 質問236 マルチクラス画像分類ディープラーニング モデルを作成します。 ...
- 質問237 自動化された機械学習を使用して、分類モデルと回帰モデルをトレ
- 質問238 Azure Machine Learning ワークスペースで自動機械学習実験を実...
- 質問239 Azure Machine Learning ワークスペースを管理しています。Azure...
- 質問240 Windows 用のディープ ラーニング仮想マシンを構成します。 次の...
- 質問241 Azure Machine Learning ワークスペースを作成します。 プライベ...
- 質問242 バイアスと分散の問題に対処するには、グローバル ペナルティ イ...
- 質問243 2,000行のデータセットがあります。Azure Learning Studioを使用...
- 質問244 次の Azure サブスクリプションと Azure Machine Learning サー...
- 質問245 フォルダーを参照する csvjolder というファイルデータセットを...
- 質問246 Azure Machine Learning を使用して、モデルをリアルタイム Web ...
- 質問247 (Exhibit) 以下の各記述について、正しい場合は「はい」を選択し...
- 質問248 分類タスクに取り組んでいます。ある生徒がサッカーをしたいかど
- 質問249 ホットスポットに関する質問 Azure Machine Learning Studio で...
- 質問250 Automated ML を使用して、Azure Machine Learning ワークスペー...
- 質問251 TSV ファイルのセットを含む Azure BLOB コンテナーがあります。...
- 質問252 Azure Machine Learning Studio で新しい実験を作成しています。...
- 質問253 ホットスポットに関する質問 Azure Machine Learning ワークスペ...
- 質問254 マルチクラス画像分類ディープラーニング モデルを作成します。 ...
- 質問255 ビジネス アプリケーションで使用されるバッチ推論パイプライン
- 質問256 Azure Machine Learning Studio を使用して実験を作成しています...
- 質問257 Azure Machine Learning ワークスペースを管理しています。ワー...
- 質問258 同僚が次のコードを使用して、機械学習サービス ワークスペース
- 質問259 トレーニング済みのモデルを Azure Machine Learning ワークスペ...
- 質問260 Azure Machine Learning を使用してモデルをトレーニングします...
- 質問261 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
- 質問262 Azure Machine Learning のリモート コンピューティングでトレー...
- 質問263 テスト要件に応じてデータを分割する方法を特定する必要がありま
- 質問264 ディープ ラーニング仮想マシン (DLVM) を使用して、Compute Uni...
- 質問265 トレーニング クラスターと推論クラスターを含む Azure Machine ...
- 質問266 Azure Machine Learning でトレーニング実験を実行する Python ...
- 質問267 畳み込みニューラルネットワークモデルを複数のエポックにわたっ
- 質問268 Azure Machine Learning ワークスペースを管理します。 ジョブの...
- 質問269 2,000行のデータセットがあります。Azure Learning Studioを使用...
- 質問270 Azure Machine Learningワークスペースがある Azure Machine Lea...
- 質問271 モデルをトレーニングするときに、Azure Machine Learning の Hy...
- 質問272 Azure ML SDK を使用して実験を実行する準備をしており、コンピ...
- 質問273 機械学習モデルを作成しています。null行を含むデータセットがあ...
- 質問274 自動車価格データ(a)を含むAzure Machine Learningデータセッ...
- 質問275 Azure Databricks ワークスペースとリンクされた Azure Machine ...
- 質問276 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
- 質問277 短い文章形式で記述された12,000件の顧客レビューを含むCSVファ...
- 質問278 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
- 質問279 Azure Machine Learning でスクリプトを実験として実行するには...
- 質問280 バイアスと分散の問題に対処するには、グローバル ペナルティ イ...
- 質問281 Azure Machine Learning Python SDK v2 のハイパーパラメータ調...
- 質問282 猫と犬を識別するためのディープラーニングモデルを構築していま
- 質問283 Azure AI Foundryプロジェクトを管理し、ベースモデルを微調整し...
- 質問284 TensorFlow を使用してディープラーニング モデルを開発していま...
- 質問285 分類タスクを解決しています。 k分割交差検証を用いて、限られた...
- 質問286 Azure Storage BLOB コンテナー用に、ml-data というデータスト...
- 質問287 Azure Machine Learning を使用して機械学習モデルを開発してい...
- 質問288 クラス A のサンプル 100 個とクラス B のサンプル 10,000 個を...
- 質問289 Azure Machine Learning ワークスペースを管理しています。Azure...
- 質問290 ビジネス アプリケーションで使用されるバッチ推論パイプライン
- 質問291 Azure Machine Learning ワークスペースと、2 つの Azure Blob S...
- 質問292 Azure Machine Learning デザイナーを使用して実験を構築してい...
- 質問293 Azureを使用して機械学習の実験を開発しています。次の画像は、...
- 質問294 アルゴリズムのハイパーパラメータを調整しています。次の表は、
- 質問295 Azure Machine Learning Studio を使用して大規模なデータストア...
- 質問296 新しい Azure サブスクリプションを作成します。サブスクリプシ...
- 質問297 新しい Azure Databricks ワークスペースを作成します。 次の図...
- 質問298 モデルのトレーニング要件に応じて早期停止基準を実装する必要が
- 質問299 Azure Machine Learning デザイナーを使用して実験を構築してい...
- 質問300 Azure Machine Learning を使用して、モデルをリアルタイム Web ...
- 質問301 Azure Machine Learning の Hyperdrive 機能を使用してモデルを...
- 質問302 二値分類を実行するためのリカレントニューラルネットワークを構
- 質問303 アルゴリズムのハイパーパラメータを調整しています。次の表は、
- 質問304 CPUベースのコンピューティングクラスターとAzure Kubernetes Se...
- 質問305 Azure Machine Learning ワークスペースでデータ ラングリングお...
- 質問306 様々な都市における住宅所有に関する人口統計データを調査する予
- 質問307 Azure Notebooks で train-classification という名前の Azure M...
- 質問308 バイナリ分類モデルを作成します。 モデルの公平性を評価するに
- 質問309 Azure Machine Learning Service を使用して、ニューラル ネット...
- 質問310 Azure Machine Learning Studio で実験を作成します。10,000 行...
- 質問311 Azure Machine Learning Studio を使用して大規模なデータストア...
- 質問312 あなたはホテル予約ウェブサイト運営会社で働くデータサイエンテ
- 質問313 Azure Machine Learning プロジェクト ファイルを含む既存の Git...
- 質問314 バイオメディカル研究会社は、実験的な医療治療試験に人々を登録
- 質問315 実験の要件とデータセットに基づいて、特徴ベースの特徴選択モジ
- 質問316 AutoMLConfig クラスを使用して、最大 10 回のモデルトレーニン...
- 質問317 Azure Machine Learning を使用してモデルをトレーニングします...
- 質問318 Azure Machine Learning デザイナーでトレーニング パイプライン...
- 質問319 クリーニングが必要な生のデータセットを分析しています。 Azure...
- 質問320 (Exhibit) 実験の実行が完了した後、Runオブジェクトのget_metri...
- 質問321 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
- 質問322 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
- 質問323 Azure Machine Learning SDK を使用して、分類モデルをトレーニ...
- 質問324 Azure Machine Learning ワークスペースを作成し、 MLflow ライ...
- 質問325 Azure Machine Learning を使用して、Bandit 早期終了ポリシーに...
- 質問326 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
- 質問327 proj1 という名前の Azure Machine Learning ワークスペースを管...
- 質問328 財務チームから、finance-data という名前の Azure Storage BLOB...
- 質問329 Azure Machine Learning ワークスペースを管理しています。ノー...
- 質問330 Azure Machine Learning モデルを作成し、モデルファイルとスク...
- 質問331 Azure Machine Learning Studio を使用して大規模なデータストア...
- 質問332 GPU ベースのトレーニングを使用して、Azure Machine Learning ...
- 質問333 Azure Machine Learning ワークスペースに保存されているデータ...
- 質問334 ホットスポットに関する質問 次の数値特徴を含む特徴セットがあ
- 質問335 Azure Machine Learning を使用してモデルをトレーニングおよび...
- 質問336 10,000 個のデータ ポイントと 150 個の特徴を持つ正規化された...
- 質問337 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
- 質問338 Azure Machine Learning ワークスペースを使用します。 次の Pyt...
- 質問339 特徴抽出方法を選択する必要があります。 どちらの方法を使用す
- 質問340 Azure Machine Learning ワークスペースを作成します。Azure Mac...
- 質問341 バイオメディカル研究会社は、実験的な医療治療試験に人々を登録
- 質問342 Azure Machine Learning ワークスペースから実行される実験を取...
- 質問343 決定木アルゴリズムを使用しています。木の深さが次の値に等しい
- 質問344 次の数値特徴を含む特徴セットがあります: X、Y、Z。 X、Y、Z 特...
- 質問345 決定木アルゴリズムを使用しています。木の深さが次の値に等しい
- 質問346 データセットの構造が一致するように、メタデータ編集モジュール
- 質問347 ペナルティ イベント検出のプロセスを定義する必要があります。 ...
- 質問348 Azure Machine Learning デザイナーでトレーニング パイプライン...
- 質問349 Azure Machine Learning ワークスペースがあります。 ワークスペ...
- 質問350 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
- 質問351 STANDARD_D1 仮想マシン イメージを使用して、ComputeOne という...
- 質問352 Azure Machine Learning ワークスペースを使用します。 次の Pyt...
- 質問353 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
- 質問354 Azure Machine Learning ワークスペースがあり、ローカルコンピ...
- 質問355 Azure Machine Learningワークスペースを作成します。ワークスペ...
- 質問356 AutoMLConfig クラスを使用して、最大 10 回のモデルトレーニン...
- 質問357 Azure Storage BLOB コンテナー用に、ml-data というデータスト...
- 質問358 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
- 質問359 Azure Machine Learning デザイナーを使用して、すべての国の国...
- 質問360 Azure Notebooks で train-classification という名前の Azure M...
- 質問361 Azure Machine Learning Studio で線形回帰モデルを開発していま...
- 質問362 ある都市の住宅販売データを含むデータセットがあります。データ
- 質問363 ドラッグアンドドロップの質問 Azure Machine Learning ワークス...
- 質問364 Azureを使用して機械学習の実験を開発しています。次の画像は、...
- 質問365 Azure Machine Learning ワークスペースがあります。 ワークスペ...
- 質問366 Azure Machine Learning デザイナーを使用して実験を構築してい...
- 質問367 Azure Machine Learning ワークスペースを作成します。Azure Mac...
- 質問368 トレーニング済みのモデルに対してリアルタイム推論サービスをデ
- 質問369 CSVファイルからテキストを前処理する予定です。Azure Machine L...
- 質問370 二項分類モデルを作成します。モデルはAzure Machine Learningワ...
- 質問371 あなたは線形回帰モデルを作成するデータ サイエンティストです
- 質問372 フォルダーを参照する csv_folder という名前のファイルデータセ...
- 質問373 CSVファイルからテキストを前処理する予定です。Azure Machine L...
- 質問374 Azure Machine Learning ワークスペースを作成し、開発環境をセ...
- 質問375 ローカル モデルの特徴抽出戦略を構築する必要があります。 コー...
- 質問376 Azure Storage BLOB コンテナー用に、ml-data というデータスト...
- 質問377 マルチクラス画像分類ディープラーニング モデルを作成します。 ...
- 質問378 データの視覚化要件に従って、診断テスト評価用の視覚化を作成す
- 質問379 画像分類用のディープラーニング畳み込みニューラルネットワーク
- 質問380 Azure Machine Learning デザイナーを使用してトレーニング パイ...
- 質問381 次の数値特徴を含む特徴セットがあります: X、Y、Z。 X、Y、Z 特...
- 質問382 機械学習モデルを開発しています。 テストのために機械学習モデ
- 質問383 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
- 質問384 群衆感情モデルの評価戦略を定義する必要があります。 順番に実
- 質問385 Azure Machine Learning プロジェクト ファイルを含む既存の Git...
- 質問386 fsi という名前のファイル システムと folder1 という名前のフォ...
- 質問387 Spark プールを使用して、Azure Machine Learning ワークスペー...
- 質問388 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
- 質問389 トレーニングと検証のエラー値に大きな差があるモデルがあります
- 質問390 モデルの適合の問題を修正する必要があります。 順番に実行する
- 質問391 Azure Machine Learning のリモート コンピューティングでトレー...
- 質問392 モデルをトレーニングするために、Azure Machine Learning コン...
- 質問393 大規模な糖尿病患者グループの年齢情報を含むデータセットを分析
- 質問394 Azure Machine Learning を使用して機械学習モデルを作成します...
- 質問395 Aunt Machine Learning を使用して機械学習モデルをトレーニング...
- 質問396 PyTorchフレームワークを使用して、多クラス画像分類ディープラ...
- 質問397 ドラッグアンドドロップの質問 Azure Machine Learning ワークス...
- 質問398 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
- 質問399 Azure Machine Learning ワークスペースとデータセットを作成し...
- 質問400 バイオメディカル研究会社は、実験的な医療治療試験に人々を登録
- 質問401 Azure ML SDK を使用してバッチ推論パイプラインを作成します。 ...
- 質問402 Azure Machine Learning Service を使用して、ニューラル ネット...
- 質問403 Azure Machine Learning Studio を使用してバイナリ分類モデルを...
- 質問404 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
- 質問405 ホットスポットに関する質問 コンピューティング先として Azure ...
- 質問406 次のように定義された 6 つのデータ ポイントを含む Python NumP...
- 質問407 群衆感情モデルの評価戦略を定義する必要があります。 順番に実
- 質問408 Azure Machine Learning ワークスペースを管理します。 Azure Da...
- 質問409 Pythonで機械学習モデルを作成しています。提供されたデータセッ...
- 質問410 Azure Al Foundry でモデル ベンチマークを確認しました。 コサ...
- 質問411 ビジネス アプリケーションで使用されるバッチ推論パイプライン
- 質問412 モデルトレーニング要件に合わせて、順列特徴重要度モジュールを
- 質問413 Python 用の Azure Machine Learning SDK を使用して、次の手順...
- 質問414 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
- 質問415 Azure Machine Learning ワークスペースで自動機械学習実験を実...
- 質問416 Azure Machine Learning SDK を使用して、分類モデルをトレーニ...
- 質問417 Azure Machine Learning ワークスペースを管理しています。ノー...
- 質問418 ホットスポットに関する質問 Azure Machine Learning を使用して...
- 質問419 以前に、CSV ファイルのフォルダーに基づく training-dataset と...
- 質問420 短い文章形式で記述された12,000件の顧客レビューを含むCSVファ...
- 質問421 外れ値を削除する前に、年齢列に外れ値が存在するかどうかを視覚
- 質問422 同僚が次のコードを使用して、機械学習サービス ワークスペース
- 質問423 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
- 質問424 ノートブックからモデルをトレーニングするためのハイパーパラメ
- 質問425 Azure Machine Learning Studio を使用して、コンピューティング...
- 質問426 Azure Machine Learning ワークスペースを作成します。 DataDrif...
- 質問427 Azure Machine Learning Service を使用して、ニューラル ネット...
- 質問428 Aunt Machine Learning を使用して機械学習モデルをトレーニング...
- 質問429 Azure Machine Learning ワークスペースを作成します。ワークス...
- 質問430 コンピューティングインスタンス「compute1」を持つAzure Machin...
- 質問431 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
- 質問432 Azure Machine Learning ワークスペースがあります。Azure Data ...
- 質問433 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
- 質問434 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
- 質問435 マルチクラス画像分類ディープラーニング モデルを作成します。 ...
- 質問436 パイプラインを実行するPythonスクリプトがあります。このスクリ...
- 質問437 ドラッグアンドドロップの質問 Azure Machine Learning ワークス...
- 質問438 短い文章形式で記述された12,000件の顧客レビューを含むCSVファ...
- 質問439 Azure Machine Learning ワークスペースに複数の機械学習モデル...
- 質問440 Azure Machine Learning Studio を使用して大規模なデータストア...
- 質問441 Azure Machine Learning Studio で線形回帰モデルを開発していま...
- 質問442 x.1、x2、x3 機能に対して scikit-learn Python ライブラリを使...
- 質問443 fsi という名前のファイル システムと folder1 という名前のフォ...
- 質問444 Azure Machine Learning Studio で多重線形回帰モデルを作成して...
- 質問445 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
- 質問446 Azure Machine Learning ワークスペースを管理します。 特徴重要...
- 質問447 workspace1 という名前の Azure Machine Learning ワークスペー...
- 質問448 WS1 という名前の Azure Machine Learning ワークスペースがあり...
- 質問449 Azure Machine Learningワークスペースがある Azure Machine Lea...
- 質問450 Azure Machine Learning Studio を使用して実験を作成しています...
- 質問451 ホットスポットに関する質問 Azure Machine Learning Studio で...
- 質問452 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
- 質問453 データセットに対して特徴エンジニアリングを実行しています。 C...
- 質問454 ペナルティ イベント検出のプロセスを定義する必要があります。 ...
- 質問455 Spark プールを使用して、Azure Machine Learning ワークスペー...
- 質問456 様々な都市における住宅所有に関する人口統計データを調査する予
- 質問457 Azure Machine Learningソリューションの実装を計画しています。...
- 質問458 既存のモデルを再トレーニングします。 モデルの現在のバージョ
- 質問459 Azure Machine Learning SDK v2 for Pythonとノートブックを使用...
- 質問460 Azure Machine Learning デザイナーを使用して、トレーニング パ...
- 質問461 データセットの構造が一致するように、メタデータ編集モジュール
- 質問462 Azure Machine Learning のトレーニング実験を実行します。トレ...
- 質問463 新しい Azure Databricks ワークスペースを作成します。 次の図...
- 質問464 モデルトレーニング要件に合わせて、順列特徴重要度モジュールを
- 質問465 Azure Machine Learning を使用して、dataset1 という名前のデー...
- 質問466 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
- 質問467 ホットスポットに関する質問 Python SDK v2 を使用して、workspa...
- 質問468 モデルトレーニング要件に合わせて、順列特徴重要度モジュールを
- 質問469 ある都市の住宅販売データを含むデータセットがあります。データ
- 質問470 モデルトレーニング要件に合わせて、順列特徴重要度モジュールを
- 質問471 人が病気にかかっているかどうかを予測するためのバイナリ分類モ
- 質問472 ホットスポットに関する質問 コンピューティング クラスターを使...
- 質問473 train.py というPythonスクリプトを作成し、scriptsというフォル...
- 質問474 テスト要件に応じてデータを分割する方法を特定する必要がありま
- 質問475 次のバージョンのモデルを登録します。 (Exhibit) Azure ML Pyth...
- 質問476 Azure Machine Learning ワークスペースがあり、ローカルコンピ...
- 質問477 Azure Machine Learning Studio で実験を作成します。10,000 行...
- 質問478 Azure Machine Learning を使用して、Bandit 早期終了ポリシーに...
- 質問479 Azure Machine Learning ワークスペースがあります。 次のコード...
- 質問480 AccessibilityToHighway 列の欠落データを置き換える必要があり...
- 質問481 マルチクラス画像分類ディープラーニング モデルを作成します。 ...
- 質問482 Python SDK v2を使用して、Azure Machine Learningワークスペー...
- 質問483 猫と犬を識別するためのディープラーニングモデルを構築していま
- 質問484 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
- 質問485 データセットの構造が一致するように、メタデータ編集モジュール
- 質問486 Azure Machine Learning Designer を使用して、次のデータセット...
- 質問487 x.1、x2、x3 機能に対して scikit-learn Python ライブラリを使...
- 質問488 Azure Machine Learning ワークスペースを管理します。 Azure Ma...
- 質問489 150以上の特徴量を含むデータセットがあります。このデータセッ...
- 質問490 Azure Machine Learning Studio で実験を作成します。10,000 行...
- 質問491 ホットスポットに関する質問 ある都市の住宅販売データを含むデ
- 質問492 ホットスポットに関する質問 Azure Machine Learning Studio を...
- 質問493 Azure Machine Learning ワークスペースとデータセットを作成し...
- 質問494 Azure Machine Learning の Hyperdrive 機能を使用してモデルを...
- 質問495 分類タスクを解決しています。 データセットのバランスが崩れて
- 質問496 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
- 質問497 Azure Machine Learning ワークスペースを作成します。 Azure Sy...
- 質問498 Spark プールを使用して、Azure Machine Learning ワークスペー...
- 質問499 Azure Machine Learning Service を使用して、ニューラル ネット...
- 質問500 機械学習モデルを作成しています。null行を含むデータセットがあ...
- 質問501 猫と犬を識別するためのディープラーニングモデルを構築していま
- 質問502 Azure Machine Learningワークスペースを作成し、srcサブフォル...
- 質問503 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
- 質問504 自動車の価格データを含むAzure Machine Learningデータセットを...
- 質問505 ビジネス アプリケーションで使用されるバッチ推論パイプライン
- 質問506 Azure Machine Learning Studio で時系列データセットを使用して...
- 質問507 広告応答のモデリング戦略を定義する必要があります。 順番に実
- 質問508 テスト要件に応じてデータを分割する方法を特定する必要がありま
- 質問509 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
- 質問510 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
