- ホーム
- Microsoft
- DP-100 - Designing and Implementing a Data Science Solution on Azure
- Microsoft.DP-100.v2026-01-29.q142
- 質問103
有効的なDP-100問題集はJPNTest.com提供され、DP-100試験に合格することに役に立ちます!JPNTest.comは今最新DP-100試験問題集を提供します。JPNTest.com DP-100試験問題集はもう更新されました。ここでDP-100問題集のテストエンジンを手に入れます。
DP-100問題集最新版のアクセス
「528問、30% ディスカウント、特別な割引コード:JPNshiken」
次のように定義された 6 つのデータ ポイントを含む Python NumPy 配列を評価します。
データ = [10, 20, 30, 40, 50, 60]
Python Scikit-learn 機械学習ライブラリの k 分割アルゴリズム埋め込みを使用して、次の出力を生成する必要があります。
電車: [10 40 50 60]、テスト: [20 30]
電車: [20 30 40 60]、テスト: [10 50]
電車: [10 20 30 50]、テスト: [40 60]
出力を生成するには、クロス検証を実装する必要があります。
コード セグメントをどのように完了する必要がありますか? 回答するには、回答領域のダイアログ ボックスで適切なコード セグメントを選択します。
注意: 正しい選択ごとに 1 ポイントが加算されます。
正解:
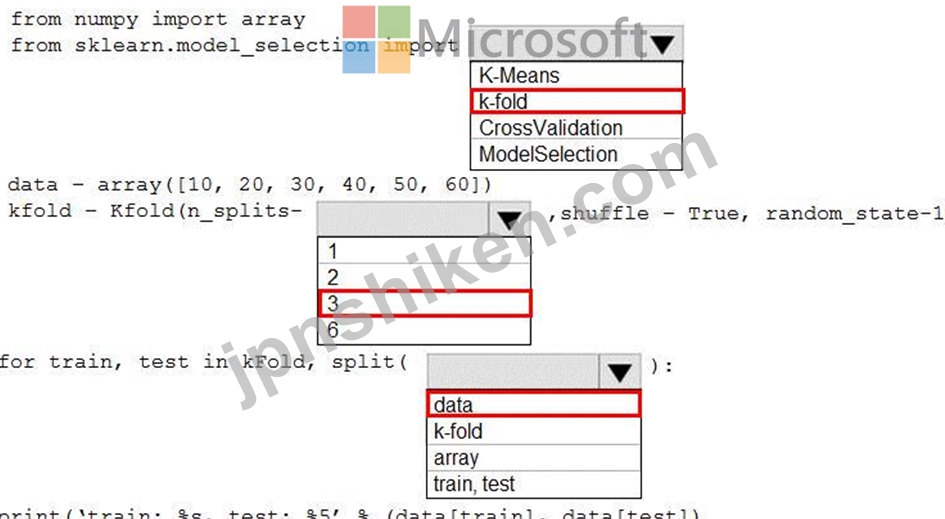
Explanation:
ボックス1: k-分割
ボックス2: 3
K-Foldsクロスバリデータは、トレーニングセットとテストセットのデータを分割するためのインデックスを提供します。データセットをk個の連続するフォールドに分割します(デフォルトではシャッフルなし)。
パラメータ n_splits ( int, デフォルト=3) は分割数です。少なくとも2である必要があります。
ボックス3: データ
例: 例:
>>>
>>> sklearn.model_selectionからKFoldをインポートします
>>> X = np.array([[1, 2], [3, 4], [1, 2], [3, 4]])
>>> y = np.array([1, 2, 3, 4])
>>> kf = KFold(n_splits=2)
>>> kf.get_n_splits(X)
2
>>> 印刷(kf)
KFold(n_splits=2、random_state=なし、shuffle=False)
>>> kf.split(X) の train_index、test_index の場合:
... print("TRAIN:", train_index, "TEST:", test_index)
... X_train、X_test = X[train_index]、X[test_index]
... y_train, y_test = y[train_index], y[test_index]
トレーニング: [2 3] テスト: [0 1]
トレーニング: [0 1] テスト: [2 3]
参考文献:
https://scikit-learn.org/stable/modules/generated/sklearn.model_selection.KFold.html

- 質問一覧「142問」
- 質問1 Azure Machine Learning を使用して、Bandit 早期終了ポリシーに...
- 質問2 バッチ推論パイプラインで使用する予定のモデルを登録します。
- 質問3 Azure Machine Learning を使用してモデルをトレーニングします...
- 質問4 特徴抽出方法を選択する必要があります。 どちらの方法を使用す
- 質問5 ビジネス アプリケーションで使用されるバッチ推論パイプライン
- 質問6 機械学習モデルが、敏感な特徴にわたって不公平な予測を生成する
- 質問7 ホットスポットに関する質問 統計分布の非対称性を分析していま
- 質問8 Azure Machine Learning ワークスペースがあります。 モデルをト...
- 質問9 音声認識ディープラーニング モデルを作成する予定です。 モデル...
- 質問10 パフォーマンス曲線の図に示されているように、広告応答モデルに
- 質問11 バイアスと分散の問題に対処するには、グローバル ペナルティ イ...
- 質問12 Azure Machine Learning Studio を使用してバイナリ分類モデルを...
- 質問13 Azure Machine Learningワークスペースがある Azure Machine Lea...
- 質問14 AmICompute クラスターとバッチ エンドポイントを含む Azure Mac...
- 質問15 大規模な糖尿病患者グループの年齢情報を含むデータセットを分析
- 質問16 ドラッグアンドドロップの質問 Azure Machine Learning デザイナ...
- 質問17 データセットに対して特徴エンジニアリングを実行しています。 C...
- 質問18 機械学習モデルをトレーニングして登録します。そして、そのモデ
- 質問19 次の形式の salesData という名前の Python データ フレームがあ...
- 質問20 Azure Machine Learning Studio を使用して大規模なデータストア...
- 質問21 ビジネス アプリケーションで使用されるバッチ推論パイプライン
- 質問22 150以上の特徴量を含むデータセットがあります。このデータセッ...
- 質問23 データの視覚化要件に従って、診断テスト評価用の視覚化を作成す
- 質問24 データセットに対して特徴エンジニアリングを実行しています。 C...
- 質問25 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
- 質問26 ホットスポットに関する質問 Azure Machine Learningワークスペ...
- 質問27 (Exhibit) 以下の各記述について、正しい場合は「はい」を選択し...
- 質問28 2,000行のデータセットがあります。Azure Machine Learning Stud...
- 質問29 Azure Machine Learning ワークスペースを作成します。Azure Mac...
- 質問30 ある組織は Azure Machine Learning サービスを使用しており、機...
- 質問31 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
- 質問32 Azure Machine Learning を使用して機械学習モデルをトレーニン...
- 質問33 Azure Machine Learning ワークスペースを使用しています。モデ...
- 質問34 Azure Machine Learning デザイナーを使用して機械学習ソリュー...
- 質問35 ディープ ラーニング仮想マシン (DLVM) を使用して、Compute Uni...
- 質問36 分類タスクに取り組んでいます。ある生徒がサッカーをしたいかど
- 質問37 ペナルティ イベント検出のプロセスを定義する必要があります。 ...
- 質問38 Azure Machine Learning を使用してモデルをトレーニングおよび...
- 質問39 Python SDK v2 を使用して、workspace1 という名前の Azure Mach...
- 質問40 2,000行のデータセットがあります。Azure Learning Studioを使用...
- 質問41 Azure Machine Learning ワークスペースを管理しています。model...
- 質問42 次の数値特徴を含む特徴セットがあります: X、Y、Z。 X、Y、Z 特...
- 質問43 Azure Machine Learning ワークスペースのノートブックから、df ...
- 質問44 Pythonで機械学習モデルを作成しています。提供されたデータセッ...
- 質問45 Workspace1 という名前の Azure Machine Learning ワークスペー...
- 質問46 Azure Machine Learning ワークスペースを作成します。 プライベ...
- 質問47 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
- 質問48 Azure Machine Learning ワークスペースを作成します。このワー...
- 質問49 Azure Machine Learning ワークスペースを使用します。 次の Pyt...
- 質問50 ディープ ラーニング仮想マシン (DLVM) を使用して、Compute Uni...
- 質問51 Azure Machine Learning ワークスペースのノートブックからパン...
- 質問52 機械学習モデルを使用してインテリジェントなソリューションを構
- 質問53 Windows 用のディープ ラーニング仮想マシンを構成します。 次の...
- 質問54 Azure Machine Learning ワークスペースのノートブックから、コ...
- 質問55 Azure Machine Learning Studio を使用して、コンピューティング...
- 質問56 Azure Machine Learning サービスで機械学習モデルをトレーニン...
- 質問57 Azure Machine Learning ワークスペースから実行される実験を取...
- 質問58 Azure ML SDK を使用して実験を実行する準備をしており、コンピ...
- 質問59 ユーザーの給与情報を含むデータセットがあります。 都市別の平
- 質問60 Azure Container Instances にモデルをデプロイします。 モデル ...
- 質問61 Azure Machine Learningワークスペースを作成します ワークスペ...
- 質問62 Azure Machine Learning ワークスペースに複数の機械学習モデル...
- 質問63 woricspace1 という名前の Azure Machine Learning ワークスペー...
- 質問64 データセットの構造が一致するように、メタデータ編集モジュール
- 質問65 Azure Machine Learning ワークスペースに複数の機械学習モデル...
- 質問66 Pythonで機械学習モデルを作成しています。提供されたデータセッ...
- 質問67 Azure Machine Learning モデルを作成し、モデルファイルとスク...
- 質問68 Azure Machine Learning ワークスペースから実行される実験を取...
- 質問69 「workspace1」という名前のAzure Machine Learningワークスペー...
- 質問70 Azure Machine Learning ワークスペースを管理しています。scrip...
- 質問71 Python SDK v2を使用して、Azure Machine Learningワークスペー...
- 質問72 Azure Machine Learning Python SDK v2 のハイパーパラメータ調...
- 質問73 短い文章形式で記述された12,000件の顧客レビューを含むCSVファ...
- 質問74 Azure Machine Learning ワークスペースの所有者です。 カスタム...
- 質問75 Azure Machine Learning サービスを使用して、training.data と...
- 質問76 Azure Storage BLOB コンテナー用に、ml-data というデータスト...
- 質問77 財務チームから、finance-data という名前の Azure Storage BLOB...
- 質問78 トレーニングと検証のエラー値に大きな差があるモデルがあります
- 質問79 Azure Machine Learning サービスを使用するデータ サイエンス ...
- 質問80 Workspace1 という名前の Azure Machine Learning ワークスペー...
- 質問81 外れ値を削除する前に、年齢列に外れ値が存在するかどうかを視覚
- 質問82 Azure Machine Learningワークスペースがある Azure Machine Lea...
- 質問83 Azure Machine Learning ワークスペースから実行される実験を取...
- 質問84 ドラッグアンドドロップの質問 Python SDK v2 を使用して、works...
- 質問85 ペナルティ イベント検出のプロセスを定義する必要があります。 ...
- 質問86 ペナルティ イベント検出のプロセスを定義する必要があります。 ...
- 質問87 モデルをトレーニングするときに、Azure Machine Learning の Hy...
- 質問88 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
- 質問89 train.py というPythonスクリプトを作成し、scriptsというフォル...
- 質問90 Azure Machine Learningモデルをトレーニングして登録します モ...
- 質問91 ユーザーが広告に反応する傾向を判断するには、モデル開発戦略を
- 質問92 computet という名前のコンピューティング インスタンスを使用し...
- 質問93 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
- 質問94 Azure Machine Learning ワークスペースがあります。 Azure Mach...
- 質問95 次の Azure サブスクリプションと Azure Machine Learning サー...
- 質問96 あなたは、画像分類用のディープ畳み込みニューラル ネットワー
- 質問97 Azure Machine Learning ワークスペースから実行される実験を取...
- 質問98 機械学習モデルを使用してインテリジェントなソリューションを構
- 質問99 次の Azure サブスクリプションと Azure Machine Learning サー...
- 質問100 Azure Machine Learning ワークスペースを作成します。Azure Mac...
- 質問101 Azure Machine Learning ワークスペースを作成します。Azure Mac...
- 質問102 Azure Machine Learning ワークスペースがあり、ローカルコンピ...
- 質問103 次のように定義された 6 つのデータ ポイントを含む Python NumP...
- 質問104 トレーニング済みのモデルに対してリアルタイム推論サービスをデ
- 質問105 モデルを Web サービスとしてデプロイするには、ノートブックで...
- 質問106 Azure Machine Learning デザイナーを使用してトレーニング パイ...
- 質問107 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
- 質問108 モデルのフレーミング要件に合わせて、順列特徴重要度モジュール
- 質問109 Azure Machine Learning Studio で線形回帰モデルを開発していま...
- 質問110 Azure Machine Learning でスクリプトを実験として実行します。 ...
- 質問111 Azure Machine Learning Studio を使用して大規模なデータストア...
- 質問112 Azure Machine Learning サービスで機械学習モデルをトレーニン...
- 質問113 自動化された機械学習を使用して、分類モデルと回帰モデルをトレ
- 質問114 Azure Machine Learning ワークスペースの所有者です。 カスタム...
- 質問115 フローを含むAzure Al Foundryプロジェクトがあります。フローに...
- 質問116 Azure Machine Learning を使用して機械学習モデルをトレーニン...
- 質問117 (Exhibit) ワークスペース内のデータや実験を操作するには、Azur...
- 質問118 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
- 質問119 ある都市の住宅販売データを含むデータセットがあります。データ
- 質問120 Azure Machine Learning ワークスペースを作成します。 プライベ...
- 質問121 猫と犬を識別するためのディープラーニングモデルを構築していま
- 質問122 Azure Machine Learning Designer を使用して、次のデータセット...
- 質問123 特徴抽出方法を選択する必要があります。 どちらの方法を使用す
- 質問124 次のバージョンのモデルを登録します。 (Exhibit) Azure ML Pyth...
- 質問125 ラベル付き写真セットを用いた多クラス画像分類ディープラーニン
- 質問126 Azure Machine Learning を使用してモデルをトレーニングします...
- 質問127 Azure Machine Learning デザイナーを使用して実験を構築してい...
- 質問128 分類タスクに取り組んでいます。ある生徒がサッカーをしたいかど
- 質問129 Azure Machine Learning ワークスペースを作成します。 次の要件...
- 質問130 Azure Machine Learning ワークスペースを管理します。 パイプラ...
- 質問131 群衆感情モデルの評価戦略を定義する必要があります。 順番に実
- 質問132 財務チームから、finance-data という名前の Azure Storage BLOB...
- 質問133 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
- 質問134 Azureを使用して機械学習の実験を開発しています。次の画像は、...
- 質問135 Azure Machine Learning Studio を使用してバイナリ分類モデルを...
- 質問136 ノートブックからモデルをトレーニングするためのハイパーパラメ
- 質問137 バイアスと分散の問題に対処するには、グローバル ペナルティ イ...
- 質問138 様々な都市における住宅所有に関する人口統計データを調査する予
- 質問139 Azure Machine Learning ワークスペースを管理しています。model...
- 質問140 Azure Machine Learning ワークスペースには、real_estate_data ...
- 質問141 Windows 用のディープ ラーニング仮想マシンを構成します。 次の...
- 質問142 バッチ推論パイプラインで使用する予定のモデルを登録します。
