有効的なAI-900問題集はJPNTest.com提供され、AI-900試験に合格することに役に立ちます!JPNTest.comは今最新AI-900試験問題集を提供します。JPNTest.com AI-900試験問題集はもう更新されました。ここでAI-900問題集のテストエンジンを手に入れます。
AI-900問題集最新版のアクセス
「336問、30% ディスカウント、特別な割引コード:JPNshiken」
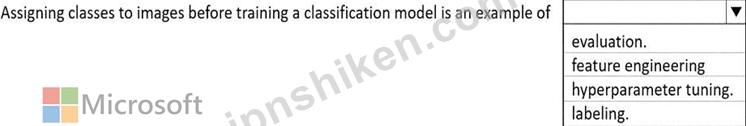
文を完成させるには、回答エリアで適切なオプションを選択してください。
正解:

Explanation:
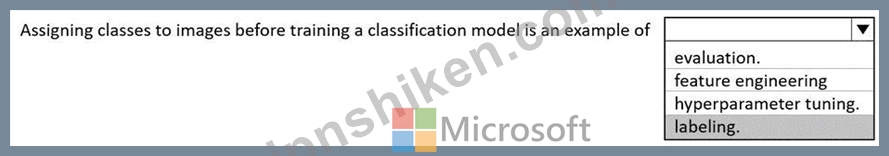
Microsoft Azure AI Fundamentals (AI-900) 公式学習ガイドとMicrosoft Learnモジュール「Azureにおける機械学習の中核概念の説明」によると、ラベリングとは、モデルのトレーニング前にトレーニングデータに正しい出力値(ラベル)を割り当てるプロセスです。教師あり学習では、データセット内のすべての入力と対応する出力をペアにして、アルゴリズムが2つの入力間の関係性を学習できるようにする必要があります。
このシナリオでは、分類モデルをトレーニングする前に、画像にクラスを割り当てることがタスクです。例えば、画像を「猫」、「犬」、「鳥」などに分類します。このプロセスによって、モデルが予測するターゲット変数(ラベル)が定義されます。トレーニング中、分類モデルはこれらのラベル付けされた例を使用してパターンを学習し、カテゴリを区別します。
Microsoft の公式資料では、ラベル付けを次のように明確に定義しています。
「モデルが予測を学習できるように、データに正しい答えをタグ付けするプロセス。」ラベリングは、機械学習ライフサイクル、特に画像分類や自然言語処理(NLP)タスクにおいて重要な初期段階です。正確なラベルがなければ、モデルは正しく学習できず、予測の信頼性が低下します。
他の選択肢がなぜ間違っているのか、簡単に説明しましょう。
* 評価とは、トレーニング後にモデルをテストし、精度、再現率、F1 スコアなどの指標を使用して精度やパフォーマンスを測定することを指します。
* 特徴エンジニアリングでは、生データから最も関連性の高い入力特徴を作成または選択することは行われますが、出力ラベルのタグ付けは行われません。
* ハイパーパラメータ調整では、ラベル付けとトレーニングの開始後にモデルのパフォーマンスを最適化するためにパラメータ (学習率やツリーの深さなど) を調整します。
したがって、モデルのトレーニングの前に画像にクラスを割り当てることは、間違いなくラベル付けタスクです。

- 質問一覧「234問」
- 質問1 「後で電話してください」などのユーザー入力の意味を解釈するた
- 質問2 サングラスをかけた人々の写真を Twitter に投稿するチャリティ...
- 質問3 AI ベースのアプリを構築しています。 アプリが責任ある AI の原...
- 質問4 Text Analytics サービスを使用するソリューションを開発してい...
- 質問5 文を正しく完成させる答えを選択してください。 (Exhibit)...
- 質問6 以下の各文について、正しい場合は「はい」を選択してください。
- 質問7 文を正しく完成させる答えを選択してください。 (Exhibit)...
- 質問8 自然言語処理ワークロードの種類を適切なシナリオに一致させます
- 質問9 文を完成させるには、回答エリアで適切なオプションを選択してく
- 質問10 文を正しく完成させる答えを選択してください。 (Exhibit)...
- 質問11 機械学習タスクを適切なシナリオに一致させます。 回答するには
- 質問12 Azure Cognitive Services を適切な AI ワークロードに一致させ...
- 質問13 以下の各文について、正しい場合は「はい」を選択してください。
- 質問14 以下の各文について、正しい場合は「はい」を選択してください。
- 質問15 Azure Cognitive Services を適切な AI ワークロードに一致させ...
- 質問16 文を完成させるには、回答エリアで適切なオプションを選択してく
- 質問17 ドローンを使って作物の列の間に雑草が生えている場所を特定し、
- 質問18 Azure Cognitive Services を適切な AI ワークロードに一致させ...
- 質問19 文を正しく完成させる答えを選択してください。 (Exhibit)...
- 質問20 文を正しく完成させる答えを選択してください。 (Exhibit)...
- 質問21 以下の各文について、正しい場合は「はい」を選択してください。
- 質問22 以下の各文について、正しい場合は「はい」を選択してください。
- 質問23 次のデータセットがあります。 (Exhibit) データセットを使用し...
- 質問24 文を正しく完成させる答えを選択してください。 (Exhibit)...
- 質問25 機械学習タスクを適切なシナリオに一致させます。 回答するには
- 質問26 手書きのメモをデジタルテキストに変換する必要があります。 ど
- 質問27 文を正しく完成させる答えを選択してください。 (Exhibit)...
- 質問28 よくある質問 (FAQ) の PDF ファイルがあります。 FAQに基づいた...
- 質問29 以下の各文について、正しい場合は「はい」を選択してください。
- 質問30 Azure Al Document Intelligence サービス (旧称 Form Recognize...
- 質問31 自然言語処理を使用して、Microsoft ニュース記事のテキストを処...
- 質問32 次のデータセットがあります。 (Exhibit) データセットを使用し...
- 質問33 以下の各文について、正しい場合は「はい」を選択してください。
- 質問34 文を完成させるには、回答エリアで適切なオプションを選択してく
- 質問35 以下の各文について、正しい場合は「はい」を選択してください。
- 質問36 文を完成させるには、回答エリアで適切なオプションを選択してく
- 質問37 簡単なユーザーの質問に答えるのに役立つビジネス チャットボッ
- 質問38 文を完成させるには、回答エリアで適切なオプションを選択してく
- 質問39 臨床データを使用して患者が病気にかかっているかどうかを予測す
- 質問40 自然言語処理を使用して、Microsoft ニュース記事のテキストを処...
- 質問41 同様の購買習慣を持つ人々のグループを識別するには、どのタイプ
- 質問42 今後 10 年間の海面をメートル単位で予測する必要があります。 ...
- 質問43 文を完成させるには、回答エリアで適切なオプションを選択してく
- 質問44 以下の各文について、正しい場合は「はい」を選択してください。
- 質問45 Azure Al Document Intelligence の事前構築済み領収書モデルを...
- 質問46 文を完成させるには、回答エリアで適切なオプションを選択してく
- 質問47 よくある質問 (FAQ) の PDF ファイルがあります。 FAQ に基づい...
- 質問48 文を完成させるには、回答エリアで適切なオプションを選択してく
- 質問49 顧客サポートシステム向けのWebベースのAIソリューションを開発...
- 質問50 文を正しく完成させる答えを選択してください。 (Exhibit)...
- 質問51 以下の各文について、正しい場合は「はい」を選択してください。
- 質問52 自然言語処理ワークロードの種類を適切なシナリオに一致させます
- 質問53 文を完成させるには、回答エリアで適切なオプションを選択してく
- 質問54 次のデータセットがあります。 (Exhibit) データセットを使用し...
- 質問55 以下の各文について、正しい場合は「はい」を選択してください。
- 質問56 文を完成させるには、回答エリアで適切なオプションを選択してく
- 質問57 文を完成させるには、回答エリアで適切なオプションを選択してく
- 質問58 ソーシャル メディアの投稿を分析してそのトーンを識別するアプ
- 質問59 文を完成させるには、回答エリアで適切なオプションを選択してく
- 質問60 AI ワークロードの種類を適切なシナリオに一致させます。 回答す...
- 質問61 文を完成させるには、回答エリアで適切なオプションを選択してく
- 質問62 文を正しく完成させる答えを選択してください。 (Exhibit)...
- 質問63 文を完成させるには、回答エリアで適切なオプションを選択してく
- 質問64 文を完成させるには、回答エリアで適切なオプションを選択してく
- 質問65 ウェブチャットボットの例となるシナリオはどれですか?
- 質問66 Text Analytics API 機能をテクニカル サポート チケット システ...
- 質問67 Azure Cognitive Services サービスを適切なアクションに一致さ...
- 質問68 音声を含まない教育ビデオが100本あります。各ビデオにはスクリ...
- 質問69 以下の各文について、正しい場合は「はい」を選択してください。
- 質問70 責任ある AI の原則を適切な説明と一致させます。 回答するには...
- 質問71 以下の各文について、正しい場合は「はい」を選択してください。
- 質問72 自然言語処理を使用してユーザーがナレッジベースを照会できるよ
- 質問73 以下の各文について、正しい場合は「はい」を選択してください。
- 質問74 医療研究プロジェクトでは、事前に定義された脳出血の種類に分類
- 質問75 以下の各文について、正しい場合は「はい」を選択してください。
- 質問76 文を正しく完成させる答えを選択してください (Exhibit)...
- 質問77 文を正しく完成させる答えを選択してください。 (Exhibit)...
- 質問78 Azure でチャットボット ソリューションを開発しています。 ユー...
- 質問79 文を正しく完成させる答えを選択してください。 (Exhibit)...
- 質問80 自動車の価格を予測するモデルを構築するには、Azure Machine Le...
- 質問81 自然言語処理ワークロードの種類を適切なシナリオに一致させます
- 質問82 Azure OpenAI 大規模言語モデル (LLM) プロセスを適切なタスクに...
- 質問83 次のデータセットがあります。 (Exhibit) データセットを使用し...
- 質問84 文を正しく完成させる答えを選択してください。 (Exhibit)...
- 質問85 文を完成させるには、回答エリアで適切なオプションを選択してく
- 質問86 次のデータセットを使用して、特定の顧客の収入範囲を予測する必
- 質問87 文を完成させるには、回答エリアで適切なオプションを選択してく
- 質問88 文を完成させるには、回答エリアで適切なオプションを選択してく
- 質問89 次のデータセットを使用して、特定の顧客の収入範囲を予測する必
- 質問90 文を完成させるには、回答エリアで適切なオプションを選択してく
- 質問91 Text Analytics API 機能をテクニカル サポート チケット システ...
- 質問92 顧客レビューを掲載したウェブサイトを運営しています。 レビュ
- 質問93 文を正しく完成させる答えを選択してください (Exhibit)...
- 質問94 デジタル写真内の有名ブランドを識別する、事前に構築されたソリ
- 質問95 Azure Machine Learning デザイナーのキャンバスにドラッグでき...
- 質問96 以下の各文について、正しい場合は「はい」を選択してください。
- 質問97 マイクロソフトの責任ある AJ 原則の例となる記述はどれですか?...
- 質問98 文を完成させるには、回答エリアで適切なオプションを選択してく
- 質問99 文を完成させるには、回答エリアで適切なオプションを選択してく
- 質問100 以下の各文について、正しい場合は「はい」を選択してください。
- 質問101 Text Analytics API 機能をテクニカル サポート チケット システ...
- 質問102 文を完成させるには、回答エリアで適切なオプションを選択してく
- 質問103 文を正しく完成させる答えを選択してください (Exhibit)...
- 質問104 ウェブチャットボットの例となるシナリオはどれですか?
- 質問105 文を正しく完成させる答えを選択してください。 (Exhibit)...
- 質問106 自然言語処理ワークロードの種類を適切なシナリオに一致させます
- 質問107 以下の各文について、正しい場合は「はい」を選択してください。
- 質問108 を選択します。 (Exhibit)
- 質問109 AI ワークロードの種類を適切なシナリオに一致させます。 回答す...
- 質問110 Azure Machine LearningパイプラインにSplit Dataモジュールが含...
- 質問111 顔認識タスクを適切な質問に一致させます。 回答するには、左側
- 質問112 分類のユースケースとは何ですか?
- 質問113 以下の各文について、正しい場合は「はい」を選択してください。
- 質問114 Azure OpenAI GPT-3.5 モデルを使用するチャット ソリューション...
- 質問115 医療研究プロジェクトでは、事前に定義された脳出血の種類に分類
- 質問116 GPT-3.5 を使用する生成 AI ソリューションによって返される応答...
- 質問117 AI ワークロードの種類を適切なシナリオに一致させます。 回答す...
- 質問118 文を完成させるには、回答エリアで適切なオプションを選択してく
- 質問119 文を正しく完成させる答えを選択してください。 (Exhibit)...
- 質問120 文を完成させるには、回答エリアで適切なオプションを選択してく
- 質問121 文を正しく完成させる答えを選択してください。 (Exhibit)...
- 質問122 以下の各文について、正しい場合は「はい」を選択してください。
- 質問123 責任ある AI の原則を適切な説明と一致させます。 回答するには...
- 質問124 文を完成させるには、回答エリアで適切なオプションを選択してく
- 質問125 文を完成させるには、回答エリアで適切なオプションを選択してく
- 質問126 次のデータセットを使用して、特定の顧客の収入範囲を予測する必
- 質問127 顔認識タスクを適切な質問に一致させます。 回答するには、左側
- 質問128 分類モデルを評価するためにどのメトリックを使用できますか?
- 質問129 文を完成させるには、回答エリアで適切なオプションを選択してく
- 質問130 以下の各文について、正しい場合は「はい」を選択してください。
- 質問131 機械学習の種類を適切なシナリオに一致させます。 回答するには
- 質問132 大量の非構造化データからデータ間の関係性を抽出することは、ど
- 質問133 以下の各文について、正しい場合は「はい」を選択してください。
- 質問134 あなたの会社は、スマートホームデバイスへの音声認識技術の活用
- 質問135 機械学習デザイナーを使用して Azure 機械学習モデルをデプロイ...
- 質問136 文を正しく完成させる答えを選択してください。 (Exhibit)...
- 質問137 画像からテキストをキャプチャすることは、どのタイプの AI 機能...
- 質問138 文を完成させるには、回答エリアで適切なオプションを選択してく
- 質問139 顔認識タスクを適切な質問に一致させます。 回答するには、左側
- 質問140 マイクロソフトの責任ある AJ 原則の例となる記述はどれですか?...
- 質問141 以下の各文について、正しい場合は「はい」を選択してください。
- 質問142 Microsoft の責任ある AI 透明性原則の例は何ですか?...
- 質問143 以下の各文について、正しい場合は「はい」を選択してください。
- 質問144 推論パイプラインを公開するには、Azure Machine Learning デザ...
- 質問145 文を完成させるには、回答エリアで適切なオプションを選択してく
- 質問146 製品の品質を予測するAzure Machine Learningモデルがあります。...
- 質問147 以下の各文について、正しい場合は「はい」を選択してください。
- 質問148 GPT-3.5 を使用する生成 AI ソリューションによって返される応答...
- 質問149 文を正しく完成させる答えを選択してください。 (Exhibit)...
- 質問150 以下の各文について、正しい場合は「はい」を選択してください。
- 質問151 サービスを適切な説明と一致させます。 回答するには、左側の列
- 質問152 文を完成させるには、回答エリアで適切なオプションを選択してく
- 質問153 文を正しく完成させる答えを選択してください。 (Exhibit)...
- 質問154 以下の各文について、正しい場合は「はい」を選択してください。
- 質問155 既存のデータセットからトレーニング データセットと検証データ
- 質問156 従業員が出張中に経費をスキャンして保存できるモバイル アプリ
- 質問157 以下の各記述について、正しい場合は「はい」を選択してください
- 質問158 以下の各文について、正しい場合は「はい」を選択してください。
- 質問159 以下の各文について、正しい場合は「はい」を選択してください。
- 質問160 分類を使用してイベントを予測するモデルを開発しています。 次
- 質問161 文を正しく完成させる答えを選択してください。 (Exhibit)...
- 質問162 責任ある AI の原則を適切な説明と一致させます。 回答するには...
- 質問163 文を完成させるには、回答エリアで適切なオプションを選択してく
- 質問164 責任ある AI に関する Microsoft の指針を適切な説明と一致させ...
- 質問165 異常検出に使用できる機械学習技術はどれですか?
- 質問166 以下の各文について、正しい場合は「はい」を選択してください。
- 質問167 文を完成させるには、回答エリアで適切なオプションを選択してく
- 質問168 機械学習のプロセスにおいて、評価指標を確認するタイミングはい
- 質問169 次のアプリがあります: * アプリ1: 腫瘍の画像セットを使用して...
- 質問170 機械学習の種類を適切なシナリオに一致させます。 回答するには
- 質問171 コンピューター ビジョンを使用して実行できる 2 つのタスクは何...
- 質問172 顧客に関する記事をニュースでチェックし、否定的な記事があれば
- 質問173 既存のデータセットからトレーニング データセットと検証データ
- 質問174 文を完成させるには、回答エリアで適切なオプションを選択してく
- 質問175 車間の距離を推定できるように、画像内の車の位置を特定する必要
- 質問176 次の図に示すような予測値と実際の値を比較したグラフがあります
- 質問177 機械学習における回帰モデルの例は何ですか?
- 質問178 写真に写っている道路標識に基づいて道路名を識別する必要があり
- 質問179 責任ある AI に関する Microsoft の指針を適切な説明と一致させ...
- 質問180 文を正しく完成させる答えを選択してください。 (Exhibit)...
- 質問181 以下の各文について、正しい場合は「はい」を選択してください。
- 質問182 Azure Machine LearningパイプラインにSplit Dataモジュールが含...
- 質問183 機械学習の種類を適切なシナリオに一致させます。 回答するには
- 質問184 文を完成させるには、回答エリアで適切なオプションを選択してく
- 質問185 文を正しく完成させる答えを選択してください。 (Exhibit)...
- 質問186 文を完成させるには、回答エリアで適切なオプションを選択してく
- 質問187 文を正しく完成させる答えを選択してください。 (Exhibit)...
- 質問188 分類モデルを評価するためにどのメトリックを使用できますか?
- 質問189 文を正しく完成させる答えを選択してください。 (Exhibit)...
- 質問190 文を完成させるには、回答エリアで適切なオプションを選択してく
- 質問191 文を完成させるには、回答エリアで適切なオプションを選択してく
- 質問192 クラスタリング モデルを作成し、Azure Machine Learning デザイ...
- 質問193 製品の品質を予測するAzure Machine Learningモデルがあります。...
- 質問194 以下の各文について、正しい場合は「はい」を選択してください。
- 質問195 GitHub Copilot はクライアント側 JavaScript の提案を行うため...
- 質問196 文を正しく完成させる答えを選択してください。 (Exhibit)...
- 質問197 自然言語処理ワークロードの種類を適切なシナリオに一致させます
- 質問198 文を完成させるには、回答エリアで適切なオプションを選択してく
- 質問199 よくある質問 (FAQ) ページを使用して、QnA Maker ボットを構築...
- 質問200 レース中のランナーの写真を処理しています。 写真に写っている
- 質問201 サービスを適切な説明と一致させます。 回答するには、左側の列
- 質問202 以下の各文について、正しい場合は「はい」を選択してください。
- 質問203 文を正しく完成させる答えを選択してください。 (Exhibit)...
- 質問204 コンピューター ビジョンを使用して実行できる 2 つのタスクは何...
- 質問205 従業員のリストとその写真が含まれるデータベースがあります。
- 質問206 音声認識を使用できるシナリオは 2 つあります。それぞれの正解...
- 質問207 文を正しく完成させる答えを選択してください。 (Exhibit)...
- 質問208 責任ある AI の原則を適切な要件に一致させます。 回答するには...
- 質問209 GPT-3.5 を使用する生成 AI ソリューションによって返される応答...
- 質問210 以下の各文について、正しい場合は「はい」を選択してください。
- 質問211 文を完成させるには、回答エリアで適切なオプションを選択してく
- 質問212 文を完成させるには、回答エリアで適切なオプションを選択してく
- 質問213 個人のデジタル写真のコレクションにラベルを付けるモデルを作成
- 質問214 機械学習タスクを適切なシナリオに一致させます。 回答するには
- 質問215 以下の各文について、正しい場合は「はい」を選択してください。
- 質問216 コンピューター ビジョンの種類を適切なシナリオに一致させます
- 質問217 Computer Vision API に画像を送信すると、展示物に表示される注...
- 質問218 文を完成させるには、回答エリアで適切なオプションを選択してく
- 質問219 文を完成させるには、回答エリアで適切なオプションを選択してく
- 質問220 Azure OpenAI GPT-3.5 モデルを使用するチャット ソリューション...
- 質問221 文を完成させるには、回答エリアで適切なオプションを選択してく
- 質問222 以下の各文について、正しい場合は「はい」を選択してください。
- 質問223 文を正しく完成させる答えを選択してください。 (Exhibit)...
- 質問224 以下の各文について、正しい場合は「はい」を選択してください。
- 質問225 従業員のリストとその写真が含まれるデータベースがあります。
- 質問226 「後で電話してください」などのユーザー入力の意味を解釈するた
- 質問227 以下の各文について、正しい場合は「はい」を選択してください。
- 質問228 以下の各文について、正しい場合は「はい」を選択してください。
- 質問229 文を完成させるには、回答エリアで適切なオプションを選択してく
- 質問230 文を正しく完成させる答えを選択してください。 (Exhibit)...
- 質問231 QnA Maker ナレッジ ベースからの応答を提供する Web チャット ...
- 質問232 文を完成させるには、回答エリアで適切なオプションを選択してく
- 質問233 Azure OpenAI 大規模言語モデル (LLM) プロセスを適切なタスクに...
- 質問234 ツールを Azure Machine Learning タスクに一致させます。 解答...
