- ホーム
- Microsoft
- AI-200 - Developing AI Cloud Solutions on Azure
- Microsoft.AI-200.v2026-11-05.q116
- 質問18
有効的なAI-200問題集はJPNTest.com提供され、AI-200試験に合格することに役に立ちます!JPNTest.comは今最新AI-200試験問題集を提供します。JPNTest.com AI-200試験問題集はもう更新されました。ここでAI-200問題集のテストエンジンを手に入れます。
AI-200問題集最新版のアクセス
「144問、30% ディスカウント、特別な割引コード:JPNshiken」
Azure Database for PostgreSQLインスタンスのデータベースリソースを構成する必要があります。
ビジネス要件と技術要件を満たすために、どのように設定を完了すればよいでしょうか?回答するには、回答欄で適切なオプションを選択してください。
注:正解ごとに1ポイントが加算されます。
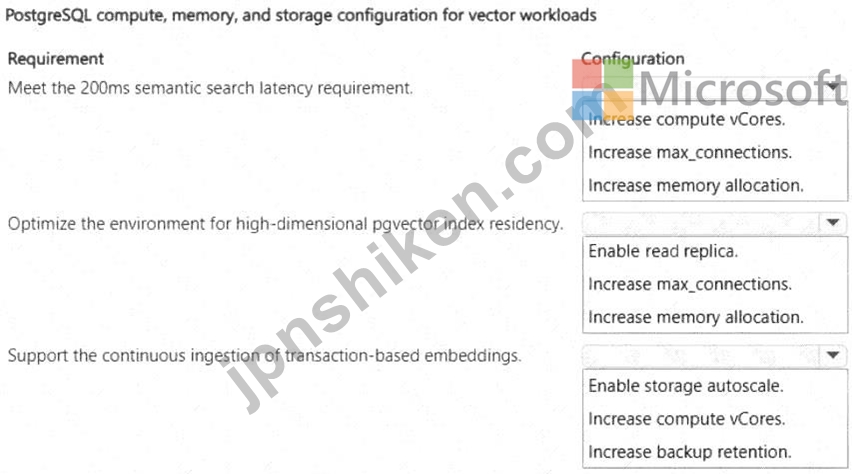
ビジネス要件と技術要件を満たすために、どのように設定を完了すればよいでしょうか?回答するには、回答欄で適切なオプションを選択してください。
注:正解ごとに1ポイントが加算されます。
正解:

Explanation:
* 200ミリ秒のセマンティック検索レイテンシ要件を満たす:コンピューティングvCoreを増やす。
* 高次元pgvectorインデックスの常駐環境を最適化する:メモリ割り当てを増やす。
* トランザクションベースの埋め込みの継続的な取り込みをサポートする:ストレージの自動スケーリングを有効にする。
200ミリ秒未満の厳密なベクトル検索レイテンシを目標とする場合、計算用vCore数を増やすことが適切な選択肢です。
ベクトル類似性演算は計算負荷が高く、CPU容量を増やすことで数学的スループットと並列クエリ実行が向上します。Microsoftのpgvectorに関するガイダンスでは、ベクトルワークロードを最適化する際に、クエリプランの最適化、HNSWなどのANNインデックス、および十分な計算リソースの確保を推奨しています。
高次元の pgvector インデックスの常駐性を確保するには、メモリ割り当てを増やしてください。HNSW は優れたクエリ性能を発揮しますが、IVFFlat よりも多くのメモリを消費します。頻繁にアクセスされるベクターインデックス構造をメモリに保持することで、ディスクアクセスを最小限に抑え、レイテンシを大幅に改善できます。Microsoft は、HNSW はより多くのメモリを必要とする一方で、速度とリコールのトレードオフにおいて優れていることを明記しています。
数百万件の埋め込みデータを継続的に取り込むには、ストレージの自動スケーリングを有効にしてください。Azure Database for PostgreSQL Flexible Server は、容量が設定されたしきい値に近づくと割り当て済みストレージを自動的に増やし、データ量の増加に伴うストレージ不足を回避します。Microsoft は、ストレージ需要が動的に増加するワークロードに対して、ストレージの自動拡張を推奨しています。
max_connections を増やしても、ベクトル計算やインデックスの常駐性は直接的に改善されません。リードレプリカは主にリードをスケーリングし、バックアップ保持は取り込み容量には対応していません。
学習ガイドの参照: Azure Database for PostgreSQL Flexible Server # pgvector パフォーマンス最適化、コンピューティングとメモリのサイジング、HNSW インデックス作成、ストレージの自動拡張。

- 質問一覧「116問」
- 質問1 セマンティック検索用のAzure Database for PostgreSQLテーブル...
- 質問2 RAGソリューションの埋め込み戦略を選択しています。ドキュメン...
- 質問3 あなたはバックエンドワーカーサービスのメッセージ処理コードを
- 質問4 ホットスポットに関する質問 あなたは、ある企業向けに検索拡張
- 質問5 ACAでアプリの新しいリビジョンをデプロイします。 パフォーマン...
- 質問6 あなたは企業向けに検索拡張生成(RAG)ソリューションを開発し...
- 質問7 あなたはAzure Functionsアプリを開発しています。 アプリのすべ...
- 質問8 あなたはAzure Container Apps上で動作する複数のマイクロサービ...
- 質問9 Azure Cosmos DB for NoSQL API のネイティブなベクトル検索機能...
- 質問10 新しくプロビジョニングされた Azure サブスクリプションがあり...
- 質問11 PostgreSQLへの同時アプリケーションリクエストのスループットを...
- 質問12 AIバッチジョブ用のサービスバスプロセッサをプロビジョニングお...
- 質問13 あなたは、ユーザーがHTTPエンドポイント経由で送信した大容量画...
- 質問14 ホットスポットに関する質問 企業向けの従量課金ホスティングプ
- 質問15 ホットスポットに関する質問 食品配達の料金支払いに使用されるW...
- 質問16 あなたのソリューションは、例えば以下のような大規模なExcelベ...
- 質問17 注:この問題は、同じシナリオを提示する一連の問題の一部です。
- 質問18 Azure Database for PostgreSQLインスタンスのデータベースリソ...
- 質問19 カスタムAI推論イベントをイベントグリッドトピックに発行します...
- 質問20 コンテナのソースコードはGitリポジトリに保存されています。 コ...
- 質問21 ドラッグアンドドロップ問題 あなたは、アプリケーションデータ
- 質問22 ドラッグアンドドロップ問題 あなたは、Key Vaultから認証情報を...
- 質問23 ドラッグアンドドロップ問題 Azure App Configurationを使用して...
- 質問24 ホットスポットに関する質問 あなたはHTTPトリガーを使用したAzu...
- 質問25 あなたはチャットボット向けに意味検索機能を実装しています。
- 質問26 Redisでは、doc:(id)という形式のキーを使用して埋め込みデータ...
- 質問27 注:この問題は、同じシナリオを提示する一連の問題の一部です。
- 質問28 ケーススタディ2 - Proseware Inc. 背景 Proseware Inc.は、企業...
- 質問29 Redisキャッシュ内のAI生成サマリーに有効期限要件を実装してい...
- 質問30 複数の Azure Service Bus キューを使用するソリューションを開...
- 質問31 あなたは、ある企業からの注文リクエストを処理するAzure Functi...
- 質問32 あなたはAzureにデプロイするJavaアプリケーションを開発してい...
- 質問33 ドラッグアンドドロップ問題 あなたは、1日に数百万件のリクエス...
- 質問34 あなたは、1日に数百万件のリクエストを処理するAI検索アプリケ...
- 質問35 ケーススタディ2 - Proseware Inc. 背景 Proseware Inc.は、企業...
- 質問36 Azure Cosmos DB for NoSQL 内で高いデータ取り込みレートに対応...
- 質問37 セマンティック検索アプリケーションは、Azure Database for Pos...
- 質問38 あなたは、公開APIを提供するAzure Functionsアプリを設計してい...
- 質問39 技術要件に基づいて、イメージ構築の自動化を設定する必要があり
- 質問40 ビジネス要件に従って、トレース相関を実装する必要があります。
- 質問41 あなたはバックエンドワーカーサービスのメッセージ処理コードを
- 質問42 大手小売企業は、オンラインストアと実店舗を運営しています。同
- 質問43 あなたは、AIによる文書処理のためにService Busを使用してメッ...
- 質問44 ホットスポットに関する質問 あなたは、Azure SDK for Pythonを...
- 質問45 テキスト読み上げ機能には、標準的なニューラル音声とは異なる、
- 質問46 AIアプリケーションは、アプリケーション構成から構成値を取得し...
- 質問47 ホットスポットに関する質問 Azure Functions Core Toolsを使用...
- 質問48 あなたは、Python APIを使用してAzure Database for PostgreSQL...
- 質問49 あなたはユーザーサポートシステム用の言語理解モデルをトレーニ
- 質問50 外部API呼び出しに依存するAzure Service Busメッセージを処理し...
- 質問51 ケーススタディ2 - Proseware Inc. 背景 Proseware Inc.は、企業...
- 質問52 ケーススタディ2 - Proseware Inc. 背景 Proseware Inc.は、企業...
- 質問53 AKSクラスター内のコンテナが繰り返し再起動する。 ノードレベル...
- 質問54 あなたは、新しいAzure Service Busキューからの注文を処理するA...
- 質問55 外部API呼び出しに依存するAzure Service Busメッセージを処理し...
- 質問56 複数の Azure Service Bus キューを使用するソリューションを開...
- 質問57 ホットスポットに関する質問 PythonのWeb APIは、トレースにOpen...
- 質問58 ホットスポットに関する質問 あなたはバックエンドワーカーサー
- 質問59 Azure Container Apps 上で動作する複数のマイクロサービスを開...
- 質問60 外部 API を呼び出すために、API へのアクセス トークンを提供す...
- 質問61 ケーススタディ1 - ファブリカム社 背景 Fabrikam Inc.は、オン...
- 質問62 Azure Cosmos DB for NoSQL コンテナー内の embedding という名...
- 質問63 あなたのソリューションは、大規模な Excel ベースのレポート (...
- 質問64 Fabrikam Inc.の技術要件およびパフォーマンス要件を満たすため...
- 質問65 ケーススタディ1 - ファブリカム社 背景 Fabrikam Inc.は、オン...
- 質問66 Azure Container Apps 上で動作する複数のマイクロサービスを開...
- 質問67 新しくプロビジョニングされた Azure サブスクリプションがあり...
- 質問68 Azure AI Foundry に GPT-40 モデルをデプロイしました。ユーザ...
- 質問69 Python SDK を使用して、Azure App Configuration リソースに保...
- 質問70 Azure Container Apps に AI サービスをデプロイしています。 サ...
- 質問71 Azure SQL Databaseに接続する本番環境用のAzure Functionsアプ...
- 質問72 あなたは、Azure Container Apps を使用するマイクロサービスベ...
- 質問73 あなたは、Azure Key Vaultから接続文字列とAPIキーを取得する、...
- 質問74 あなたは、Azure Container Apps を使用するマイクロサービスベ...
- 質問75 ある企業がAzure Cosmos DB for NoSQLアカウントを保有している...
- 質問76 - 本番環境へのデプロイに向けてコンテナイメージを準備していま...
- 質問77 ドラッグアンドドロップ問題 新しくプロビジョニングされた Azur...
- 質問78 サポートコール中に、顧客との会話を英語からスペイン語のテキス
- 質問79 Azure App Service API アプリ(api1 という名前)にコンテナを...
- 質問80 ドラッグアンドドロップ問題 AIバッチジョブ用のサービスバスプ...
- 質問81 ホットスポットに関する質問 あなたは、Azure Cosmos DB for NoS...
- 質問82 あなたは、セマンティック検索用のAzure Database for PostgreSQ...
- 質問83 あなたは、アプリケーションデータを保存するためにAzure Cosmos...
- 質問84 ホットスポットに関する質問 あなたは、分散トレースをAzure Mon...
- 質問85 Azure Storage Blobへのアップロードは、バックエンド処理をトリ...
- 質問86 あなたは、セマンティック検索結果をRedisにキャッシュするAI検...
- 質問87 あなたは、ユーザーがHTTPエンドポイント経由で送信した大容量画...
- 質問88 コンテナ化されたレコメンデーションAPIから、安全なデータベー...
- 質問89 アプリケーションは、アップロードされた製品画像を、貴社固有の
- 質問90 ケーススタディ2 - Proseware Inc. 背景 Proseware Inc.は、企業...
- 質問91 断続的な接続問題が発生している本番環境の Azure OpenAI サービ...
- 質問92 アプリケーションは会話履歴を保存し、複数ターンのチャットボッ
- 質問93 あなたはチャットボット向けのセマンティック検索機能を構築して
- 質問94 ドラッグアンドドロップ問題 Python APIは、SQL文を使用してAzur...
- 質問95 あなたはAzure上でサーバーレスJavaアプリケーションを開発して...
- 質問96 Azure Container App をデプロイする予定です。 コンテナアプリ...
- 質問97 あなたは、新しい Azure Kubernetes Service クラスターにデプロ...
- 質問98 コストが急増するのを避けるため、Azure OpenAI を利用したアプ...
- 質問99 このアプリケーションは、pgvectorを使用してAzure Database for...
- 質問100 パートナー向けサービス用の接続文字列は、技術要件に従って設定
- 質問101 あなたは、病院向けに以下のユースケースをサポートするソリュー
- 質問102 ホットスポットに関する質問 App ServiceにLinuxコンテナイメー...
- 質問103 ホットスポットに関する質問 Azure Service Bus の名前空間に、T...
- 質問104 あなたは、音声および視覚アラームの開始と停止をトリガーする単
- 質問105 ホットスポットに関する質問 企業向けの従量課金ホスティングプ
- 質問106 ホットスポットに関する質問 Azure Container Registry (ACR) か...
- 質問107 既存のAKSクラスターと、Azure Container Registryに保存されて...
- 質問108 Azure Cosmos DB をデータストアとして使用する Azure Web アプ...
- 質問109 アップロードされた画像に成人向けコンテンツや暴力的なコンテン
- 質問110 ホットスポットに関する質問 あなたは、ユーザーの入力に基づい
- 質問111 コンテナのソースコードはGitリポジトリに保存されています。 コ...
- 質問112 ドラッグアンドドロップ問題 既存のAKSクラスターと、Azure Cont...
- 質問113 ホットスポットに関する質問 Azure Monitor のリクエスト テーブ...
- 質問114 HTTP トリガー型の Azure Function は、Azure Blob Storage に保...
- 質問115 ドラッグアンドドロップ問題 Azure Cosmos DB for NoSQL API の...
- 質問116 Sub1 という名前の Azure サブスクリプションがあり、その中に R...
