- ホーム
- VMware
- 3V0-24.25 - Advanced VMware Cloud Foundation 9.0 vSphere Kubernetes Service
- VMware.3V0-24.25.v2026-11-21.q80
- 質問44
有効的な3V0-24.25問題集はJPNTest.com提供され、3V0-24.25試験に合格することに役に立ちます!JPNTest.comは今最新3V0-24.25試験問題集を提供します。JPNTest.com 3V0-24.25試験問題集はもう更新されました。ここで3V0-24.25問題集のテストエンジンを手に入れます。
3V0-24.25問題集最新版のアクセス
「85問、30% ディスカウント、特別な割引コード:JPNshiken」
管理者が VMware Cloud Foundation (VCF) Supervisor をアップグレードしようとしたところ、アップグレードが失敗しました。失敗の原因を特定するために管理者が取るべき手順を順番に並べてください。
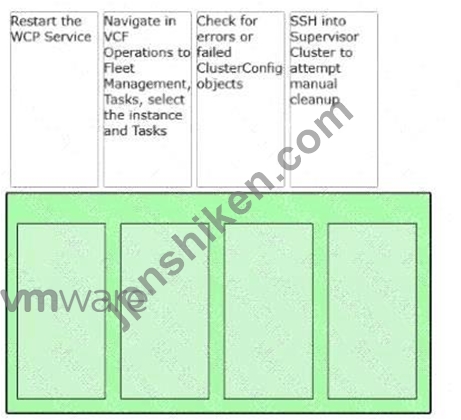
正解:

Explanation:
回答(正しい順序):
* VCF OperationsでFleet Management # Tasksに移動し、インスタンスを選択してタスクを確認します。
* エラーまたは失敗した ClusterConfig オブジェクトがないか確認します。
必要に応じて、SSHでスーパーバイザークラスタに接続してログを確認し、手動でクリーンアップを試みます。
* WCPサービスを再起動します
Supervisor のアップグレードが失敗した理由を特定するには、プラットフォームが最も対応可能な障害コンテキストを記録する場所、つまり管理プレーンのタスク履歴から始めます。Fleet/Task ビューには、アップグレード ワークフローの手順、タイムスタンプ、および失敗した特定の操作が表示され、失敗したフェーズ (事前チェック、イメージのステージング、調整、アドオンの更新など) を最も迅速に特定できます。次に、失敗した ClusterConfig オブジェクトをチェックして Kubernetes 側の調整状態を検証します。これは、Supervisor の有効化/アップグレード アクションがコントローラーの調整を介して構成を駆動することが一般的であるためです。失敗した ClusterConfig には、進行を妨げた原因 (検証エラー、依存関係の問題、到達不能なエンドポイント、互換性のないコンポーネント) を説明する最も明確な「理由」および「メッセージ」フィールドが含まれていることがよくあります。
管理プレーン/タスクビューと ClusterConfig ステータスで根本原因を特定できない場合は、次のエスカレーションとして、Supervisor に SSH で接続し、コンポーネントのログ/イベントを検査して、適切に上位に伝播しない可能性のある低レベルの障害 (たとえば、アクセス失敗、コントローラのクラッシュ、接続/認証の問題など) を特定します。
最後に、WCPの再起動は、スタック状態を解消できる修復手順ですが、証拠を改変する可能性があるため、最後に行うべき手順です。また、元の障害原因を特定しようとしている段階では、最初に行うべきではありません。

- 質問一覧「80問」
- 質問1 vSphere with Tanzu環境への認証時に、kubectl用vSphereプラグイ...
- 質問2 プラットフォームエンジニアが、Tanzu Kubernetes Grid(TKG)ク...
- 質問3 プラットフォームエンジニアは、大量のバッチ処理ワークロードに
- 質問4 VKS管理者は、リソースを解放するために、スーパーバイザーサー...
- 質問5 In the context of vSphere with Tanzu, what is the specific r...
- 質問6 クラウド管理者は、vSphere with Tanzu環境の設計を行っています...
- 質問7 A Cloud Administrator is evaluating the use of Custom Ingres...
- 質問8 クラウドアーキテクトが、フェデレーション機能を備えた複数サイ
- 質問9 VI管理者は、TKRコンテンツライブラリが消費するディスク容量を...
- 質問10 セキュリティアーキテクトは、新しいTKGクラスター群の認証を提...
- 質問11 A platform operator runs a kubectl command and receives the ...
- 質問12 管理者がVMware vSphere Kubernetes Service(VKS)クラスタのク...
- 質問13 VMware vSphere Kubernetes Service (VKS) アーキテクチャにおい...
- 質問14 An administrator had deployed a Supervisor cluster on vSpher...
- 質問15 VI管理者は、重要なステートフルワークロードを実行しているprod...
- 質問16 VMware vSphere Kubernetes Service (VKS) 上でアプリケーション...
- 質問17 クラウド管理者は、新しいスーパーバイザー展開のためのIPアドレ...
- 質問18 DevOps エンジニアは、vSphere 名前空間内の vSphere Kubernetes...
- 質問19 プラットフォームエンジニアは、独自の入退室管理システム向けに
- 質問20 vSphere with Tanzuアーキテクチャにおいて、スーパーバイザーク...
- 質問21 vSphere Supervisor Clusterを新しいバージョンにアップグレード...
- 質問22 A VKS administrator is tasked to leverage day-2 controls to ...
- 質問23 Drag and drop the three features into the correct order from...
- 質問24 VI管理者は、VMサービスで使用されるVMイメージのライフサイクル...
- 質問25 クラウド管理者が、finance-prod という名前の vSphere 名前空間...
- 質問26 次のうち、vSphere with Tanzu環境におけるvSphereネームスペー...
- 質問27 vSphere Supervisor をアップグレードした後、管理者は、コア ス...
- 質問28 DevOpsエンジニアが新しいマイクロサービスアプリケーションのデ...
- 質問29 管理者が既存のVMware vSphere Kubernetes Service(VKS)クラス...
- 質問30 An administrator is tasked to create a new vSphere Zone for ...
- 質問31 管理者が既存のネームスペースにKubernetesクラスターを追加して...
- 質問32 あるアーキテクトが、VMware Cloud Foundation (VCF) ソリューシ...
- 質問33 VKS管理者がパッケージのインストール失敗のトラブルシューティ...
- 質問34 セキュリティ運用アナリストが、マルチテナント型の金融アプリケ
- 質問35 開発者が、kubectl vspher login コマンドを使用して特定の TKG ...
- 質問36 管理者は、vSphere Kubernetes Service 環境の Supervisor Names...
- 質問37 クラウドアーキテクトが、高可用性のKafkaクラスタをサポートす...
- 質問38 セキュリティ運用アナリストは、TKGクラスタで使用されるすべて...
- 質問39 VMware vSphere Kubernetes Service (VKS) でサポートされている...
- 質問40 管理者は、vSphere Kubernetes Service (VKS) クラスタのオート...
- 質問41 A Platform Engineer is deploying a StatefulSet in a vSphere ...
- 質問42 プラットフォームエンジニアは、vcf-cliツール(またはVKSプラグ...
- 質問43 vSphere with Tanzu環境において、vSphere Podを標準的な仮想マ...
- 質問44 管理者が VMware Cloud Foundation (VCF) Supervisor をアップグ...
- 質問45 VMware vSphere Kubernetes Service (VKS) クラスタのライフサイ...
- 質問46 管理者が既存の Tanzu Kubernetes Cluster (TKC) のアップグレー...
- 質問47 VMware Kubernetes Service (VKS) クラスタが提供する4つの機能...
- 質問48 VI管理者は、開発者向けにローカルで安全なリポジトリを提供する...
- 質問49 VI管理者は、クラウドネイティブアプリケーションとレガシーデー...
- 質問50 The administrator has completed a proof of concept for using...
- 質問51 An administrator is deploying vSphere Kubernetes Service (VK...
- 質問52 管理者がvCenterでスーパーバイザーサービスを設定しています。 ...
- 質問53 VMware vSphere Kubernetes Service (VKS) のどの機能が、永続ボ...
- 質問54 VMware vSphere Kubernetes Service (VKS) クラスタの外部IDプロ...
- 質問55 A VI Administrator needs to expand the available storage opt...
- 質問56 クラウド管理者は、名前空間用のNSXセグメントをサポートするス...
- 質問57 VMware vSphere Kubernetes Service (VKS) サービスメッシュの目...
- 質問58 An administrator is maintaining several Kubernetes clusters ...
- 質問59 クラウドアーキテクトが、Harbor Supervisor Serviceのリソース...
- 質問60 VMware vSphereとvSphere Supervisorにおいて、VMクラスで構成で...
- 質問61 名前空間の権限を設定するために使用されるKubernetesオブジェク...
- 質問62 管理者は、マルチゾーン対応のvSphere環境でSupervisorクラスタ...
- 質問63 クラウド管理者が、VDSネットワークを使用したNSX Advanced Load...
- 質問64 What is the function ofContourin a VMware vSphere Kubernetes...
- 質問65 An administrator had deployed a Supervisor cluster on vSpher...
- 質問66 管理者が VKS 3.4 にアップグレードしている際に、ワークロード ...
- 質問67 VMware vSphere Kubernetes Service (VKS) ポッドは、非永続デー...
- 質問68 セキュリティ運用アナリストは、開発者がTKGクラスタに対して認...
- 質問69 VKS管理者が、analytics-clusterという名前でプロビジョニングさ...
- 質問70 An administrator must create amulti-zone vSphere Supervisord...
- 質問71 vSphere with Tanzu環境におけるvSphere Supervisorのアーキテク...
- 質問72 Drag and drop the three features into the correct order from...
- 質問73 DevOpsエンジニアが、vSphere with Tanzuに含まれるVMサービス(...
- 質問74 管理者は、vSphere Kubernetes Service (VKS) クラスタのオート...
- 質問75 VKS管理者が、新しいワーカーノードのプロビジョニングは正常に...
- 質問76 管理者は、VMware vSphere Kubernetes Service (VKS) 用の Istio...
- 質問77 VKS 管理者は、負荷の増加に対応するため、prod-cluster-01 とい...
- 質問78 アーキテクトが顧客と打ち合わせを行い、vSphere Kubernetes Ser...
- 質問79 管理者は、特定の時点におけるVKSクラスタを保護する任務を負っ...
- 質問80 プラットフォームエンジニアは、ミッションクリティカルなアプリ
