有効的なDP-203問題集はJPNTest.com提供され、DP-203試験に合格することに役に立ちます!JPNTest.comは今最新DP-203試験問題集を提供します。JPNTest.com DP-203試験問題集はもう更新されました。ここでDP-203問題集のテストエンジンを手に入れます。
DP-203問題集最新版のアクセス
「365問、30% ディスカウント、特別な割引コード:JPNshiken」
CSVファイルからデータを取り込み、指定されたタイプのデータに列をキャストし、Azure SynapseAnalytic専用SQLプールのテーブルにデータを挿入するAzureDataFactoryデータフローを作成しています。CSVファイルには、username、comment、およびdateという名前の3つの列が含まれています。
データフローには、すでに次のものが含まれています。
*ソース変換。
*適切なタイプのデータを設定するための派生列変換。
*データをプールに配置するためのシンク変換。
データフローが次の要件を満たしていることを確認する必要があります。
*すべての有効な行を宛先テーブルに書き込む必要があります。
*コメント列の切り捨てエラーは事前に回避する必要があります。
*挿入時に切り捨てエラーが発生するコメント値を含む行は、BLOBストレージ内のファイルに書き込む必要があります。
実行する必要がある2つのアクションはどれですか?それぞれの正解は、解決策の一部を示しています。
注:正しい選択はそれぞれ1ポイントの価値があります。
データフローには、すでに次のものが含まれています。
*ソース変換。
*適切なタイプのデータを設定するための派生列変換。
*データをプールに配置するためのシンク変換。
データフローが次の要件を満たしていることを確認する必要があります。
*すべての有効な行を宛先テーブルに書き込む必要があります。
*コメント列の切り捨てエラーは事前に回避する必要があります。
*挿入時に切り捨てエラーが発生するコメント値を含む行は、BLOBストレージ内のファイルに書き込む必要があります。
実行する必要がある2つのアクションはどれですか?それぞれの正解は、解決策の一部を示しています。
注:正しい選択はそれぞれ1ポイントの価値があります。
正解:A,B
B:例:
1.この条件付き分割変換では、「タイトル」の最大長を5と定義しています。5以下の行は、GoodRowsストリームに入ります。5より大きい行は、BadRowsストリームに入ります。
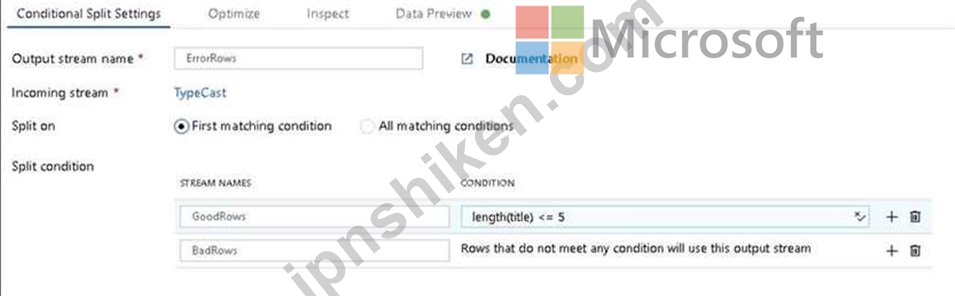
2.この条件付き分割変換では、「タイトル」の最大長を5と定義しています。5以下の行は、GoodRowsストリームに入ります。5より大きい行は、BadRowsストリームに入ります。
NS:
3.次に、失敗した行をログに記録する必要があります。ロギング用にシンク変換をBadRowsストリームに追加します。ここでは、すべてのフィールドを「自動マップ」して、完全なトランザクションレコードのログを記録します。これは、BlobStorage内の単一のファイルに出力されるテキスト区切りのCSVファイルです。ログファイルを「badrows.csv」と呼びます。
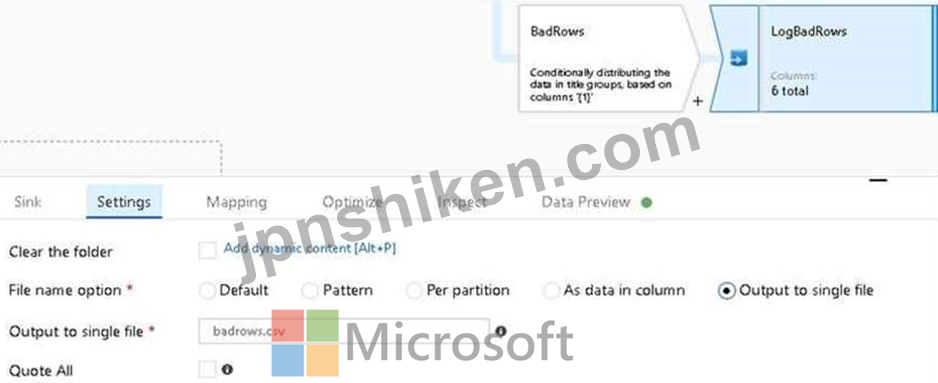
4.完成したデータフローを以下に示します。これで、エラー行を分割してSQL切り捨てエラーを回避し、それらのエントリをログファイルに入れることができます。その間、成功した行は引き続きターゲットデータベースに書き込むことができます。

リファレンス:
https://docs.microsoft.com/en-us/azure/data-factory/how-to-data-flow-error-rows
1.この条件付き分割変換では、「タイトル」の最大長を5と定義しています。5以下の行は、GoodRowsストリームに入ります。5より大きい行は、BadRowsストリームに入ります。
2.この条件付き分割変換では、「タイトル」の最大長を5と定義しています。5以下の行は、GoodRowsストリームに入ります。5より大きい行は、BadRowsストリームに入ります。
NS:
3.次に、失敗した行をログに記録する必要があります。ロギング用にシンク変換をBadRowsストリームに追加します。ここでは、すべてのフィールドを「自動マップ」して、完全なトランザクションレコードのログを記録します。これは、BlobStorage内の単一のファイルに出力されるテキスト区切りのCSVファイルです。ログファイルを「badrows.csv」と呼びます。
4.完成したデータフローを以下に示します。これで、エラー行を分割してSQL切り捨てエラーを回避し、それらのエントリをログファイルに入れることができます。その間、成功した行は引き続きターゲットデータベースに書き込むことができます。
リファレンス:
https://docs.microsoft.com/en-us/azure/data-factory/how-to-data-flow-error-rows

- 質問一覧「149問」
- 質問1 注:この質問は、同じシナリオを提示する一連の質問の一部です。
- 質問2 AzureSynapseにSQLプールがあります。 AzureBlobストレージから...
- 質問3 Azure StreamAnalyticsクエリがあります。クエリは、clusterIDと...
- 質問4 ペタバイトの医用画像データを保存するアプリケーションを設計し
- 質問5 Storage1とStorage2という名前の2つのAzureStorageアカウントが...
- 質問6 Azure SynapseAnalytics専用のSQLプールを設計しています。 次の...
- 質問7 SQLServerからAzureData LakeStorageに毎日のインベントリデータ...
- 質問8 Server1という名前の論理MicrosoftSQLサーバーを含むAzureサブス...
- 質問9 Azure Data Factoryを使用して、Azure SynapseAnalyticsサーバー...
- 質問10 Twitterフィードデータを専用のSQLプールで分析できることを確認...
- 質問11 次のリソースを含むAzureサブスクリプションがあります。 * Grou...
- 質問12 10個のパイプラインを含むAzureDataFactoryがあります。 各パイ...
- 質問13 Azure SynapseAnalytics専用のSQLプールを作成する予定です。 会...
- 質問14 料金所を通過する車両からのストリーミングデータを処理していま
- 質問15 注:この質問は、同じシナリオを提示する一連の質問の一部です。
- 質問16 AzureDatabricksを使用するストリーミングデータソリューション...
- 質問17 企業全体のAzureData Lake StorageGen2アカウントがあります。デ...
- 質問18 小売店テーブルの代理キーを実装する必要があります。ソリューシ
- 質問19 Azure StreamAnalyticsを使用してストリーミングソーシャルメデ...
- 質問20 次の展示に示すように、AzureSynapseワークスペース用のファイル...
- 質問21 次の展示に示すように、Azure SynapseAnalyticsのデータウェアハ...
- 質問22 AzureDatabricksを使用するストリーミングデータソリューション...
- 質問23 Server1という名前の論理MicrosoftSQLサーバー上にPool1という名...
- 質問24 小売環境のセンサーからの着信イベントを処理するAzureStreamAna...
- 質問25 Twitterフィードデータを専用のSQLプールで分析できることを確認...
- 質問26 注:この質問は、同じシナリオを提示する一連の質問の一部です。
- 質問27 Azureイベントハブからインスタントメッセージングデータを受信...
- 質問28 英国南部地域のAzureSynapseAnalyticsにAzureStorageアカウント...
- 質問29 顧客用のJSONファイルを含むAzureData Lake StorageGen2アカウン...
- 質問30 ファイルがAzureData Lake Storage Gen2コンテナーに到着したと...
- 質問31 Azure SynapseAnalyticsでエンタープライズデータウェアハウスを...
- 質問32 仮想ネットワークサービスエンドポイントが構成されているAzureD...
- 質問33 顧客用のJSONファイルを含むAzureData Lake StorageGen2アカウン...
- 質問34 リアルタイムデータ処理ソリューションの高可用性を向上させるた
- 質問35 Azure Stream Analyticsを使用して、Azure Event HubsからTwitte...
- 質問36 Azure Data Factoryパイプラインを構築して、Azure Data Lake St...
- 質問37 ある会社は、ApacheSpark分析を使用して侵入検知データを分析す...
- 質問38 新しいファイルがAzureData Lake Storage Gen2コンテナーに到着...
- 質問39 さまざまな量のデータを取り込むストリーミングデータソリューシ
- 質問40 Azure Data Lake StorageGen2アカウントのフォルダー構造を設計...
- 質問41 標準料金階層にworkspace1という名前のAzureDatabricksワークス...
- 質問42 Azure SynapseAnalytics専用のSQLプールを作成する予定です。 会...
- 質問43 販売トランザクションデータを格納するために、Azure SynapseAna...
- 質問44 Table1という名前のテーブルを含むSA1という名前のAzureSynapseA...
- 質問45 Azure SynapseAnalyticsでエンタープライズデータウェアハウスを...
- 質問46 Azure Data LakeGen2ストレージアカウントを実装することを計画...
- 質問47 注:この質問は、同じシナリオを提示する一連の質問の一部です。
- 質問48 16個のパーティションを持つretailhubという名前のAzureイベント...
- 質問49 Azure SynapseAnalytics専用のSQLプール内のファクトテーブルの...
- 質問50 Pool1という名前のAzureSynapse Analytics ApacheSparkプールが...
- 質問51 さまざまな量のデータを取り込むストリーミングデータソリューシ
- 質問52 Pool1という名前のAzureSynapse Analytics専用SQLプールと、DB1...
- 質問53 小売環境のセンサーからの着信イベントを処理するAzureStreamAna...
- 質問54 SQLServerからAzureData LakeStorageに毎日のインベントリデータ...
- 質問55 CSVファイルを含むAzureData Lake StorageGen2コンテナーを実装...
- 質問56 Azure Databricksを使用して、DBTBL1という名前のデータセットを...
- 質問57 ある会社には、MicrosoftAzureでホストされているリアルタイムの...
- 質問58 注:この質問は、同じシナリオを提示する一連の質問の一部です。
- 質問59 ある会社は、Platform-as-a-Service(PaaS)を使用して新しいデ...
- 質問60 注:この質問は、同じシナリオを提示する一連の質問の一部です。
- 質問61 MicrosoftAzureでLambdaアーキテクチャを使用してソリューション...
- 質問62 ペタバイトの医用画像データを保存するアプリケーションを設計し
- 質問63 Azure Data Lake StorageGen2を使用します。 データがディスクか...
- 質問64 Employeesという名前の次のテーブルがあります。 (Exhibit) あな...
- 質問65 10個のパイプラインを含むAzureDataFactoryがあります。 各パイ...
- 質問66 次のコードセグメントは、AzureDatabricksクラスターを作成する...
- 質問67 次のファクトテーブルを含むオンプレミスのデータウェアハウスが
- 質問68 ファイルはAzureData Lake StorageGen2コンテナーに保存します。...
- 質問69 Azure Data Factoryを使用して、Azure SynapseAnalyticsサーバー...
- 質問70 mytestdbという名前のApacheSparkデータベースを含むMyWorkspace...
- 質問71 Azure Databricksを使用して、DBTBL1という名前のデータセットを...
- 質問72 CSVファイルからデータを取り込み、指定されたタイプのデータに...
- 質問73 次の表に示すユーザーを含むAzureSynapseAnalytics専用のSQLプー...
- 質問74 機密性の高い顧客の連絡先情報を保護するために何を使用すること
- 質問75 Azure SynapseAnalytics専用のSQLプールにパーティションテーブ...
- 質問76 Azure SynapseAnalytics専用のSQLプールにテーブルがあります。...
- 質問77 Azure IoTハブからのデータを処理し、複雑な変換を実行するC#ア...
- 質問78 Azure Data Lake StorageGen2コンテナーのフォルダー構造を設計...
- 質問79 AzureSynapseにSQLプールがあります。 ユーザーから、プールに対...
- 質問80 Azure StreamAnalyticsジョブを監視しています。 過去1時間のバ...
- 質問81 次の展示に示すように、AzureSynapseワークスペース用のファイル...
- 質問82 ペタバイトの医用画像データを保存するアプリケーションを設計し
- 質問83 英国南部地域のAzureSynapseAnalyticsにAzureStorageアカウント...
- 質問84 Azureデータファクトリがあります。 最後の180フレイからのパイ...
- 質問85 Pipeline1とPipeline2という名前の2つのパイプラインを含むAzure...
- 質問86 注:この質問は、同じシナリオを提示する一連の質問の一部です。
- 質問87 小売環境のセンサーからの着信イベントを処理するAzureStreamAna...
- 質問88 機密性の高い顧客の連絡先情報を保護するために何を使用すること
- 質問89 Azure StreamAnalyticsウィンドウ関数を実装しています。 要件ご...
- 質問90 DW1という名前のAzureSynapseAnalyticsのエンタープライズデータ...
- 質問91 小売店テーブルの代理キーを実装する必要があります。ソリューシ
- 質問92 Pool1という名前のAzureSynapse AnalyticsサーバーレスSQLプール...
- 質問93 Azure SynapseAnalyticsにエンタープライズデータウェアハウスが...
- 質問94 Azure Stream Analyticsジョブを構築して、ユーザーがWebページ...
- 質問95 オンライン注文のレコードを含むデータセットのスタースキーマを
- 質問96 次のリソースを含むAzureサブスクリプションがあります。 * Grou...
- 質問97 Microsoft AzureSQLデータウェアハウス実装の監視を構成します。...
- 質問98 ある会社は、Platform-as-a-Service(PaaS)を使用して新しいデ...
- 質問99 ファイルがAzureData Lake Storage Gen2コンテナーに到着したと...
- 質問100 Employeesという名前の次のテーブルがあります。 (Exhibit) 雇用...
- 質問101 リアルタイムデータ処理ソリューションの高可用性を向上させるた
- 質問102 デバイスが指定された場所から200メートル以上離れたときにユー...
- 質問103 1時間ごとにトリガーされるAzureDataFactoryパイプラインがあり...
- 質問104 Azure DataFactoryに自己ホスト型の統合ランタイムがあります。 ...
- 質問105 ADFdevとADFprodという名前の2つのAzureDataFactoryインスタンス...
- 質問106 注:この質問は、同じシナリオを提示する一連の質問の一部です。
- 質問107 Webサイト分析システムから、ダウンロード、リンククリック、フ...
- 質問108 ある会社が製造機械を監視するためにIoTデバイスを購入していま...
- 質問109 次の展示に示すように、Azure SynapseAnalyticsのデータウェアハ...
- 質問110 Group1という名前のセキュリティグループを含むAzureActive Dire...
- 質問111 次のファクトテーブルを含むオンプレミスのデータウェアハウスが
- 質問112 Webサイト分析システムから、ダウンロード、リンククリック、フ...
- 質問113 CSVファイルからデータを取り込み、指定されたタイプのデータに...
- 質問114 製品販売トランザクションのパーティションを設計する必要があり
- 質問115 注:この質問は、同じシナリオを提示する一連の質問の一部です。
- 質問116 次のAzureDataFactoryパイプラインがあります *システム1からデ...
- 質問117 AzureSynapseにSQLプールがあります。 ユーザーから、プールに対...
- 質問118 ペタバイトの医用画像データを保存するアプリケーションを設計し
- 質問119 Twitterフィード用のデータ取り込みおよびストレージソリューシ...
- 質問120 注:この質問は、同じシナリオを提示する一連の質問の一部です。
- 質問121 AzureSynapseにSQLプールがあります。 一部のクエリが失敗するか...
- 質問122 Group1という名前のセキュリティグループを含むAzureActive Dire...
- 質問123 注:この質問は、同じシナリオを提示する一連の質問の一部です。
- 質問124 Azure SynapseAnalytics専用のSQLプールにパーティションテーブ...
- 質問125 製品販売トランザクションのパーティションを設計する必要があり
- 質問126 ある会社が製造機械を監視するためにIoTデバイスを購入していま...
- 質問127 CSVファイルからデータを取り込み、指定されたタイプのデータに...
- 質問128 Azure SynapseAnalytics専用のSQLプールにパーティションテーブ...
- 質問129 温度という名前のApacheSparkDataFrameがあります。データのサン...
- 質問130 Azureデータファクトリがあります。 パイプライン実行データが12...
- 質問131 Pool1という名前のAzureSynapse Analytics専用SQLプールと、DB1...
- 質問132 Azure Data Lake StorageGen2の導入を計画しています。 データレ...
- 質問133 AzureDatabricksテーブルを設計しています。このテーブルは、1日...
- 質問134 Storage1とStorage2という名前の2つのAzureStorageアカウントが...
- 質問135 Azure StreamAnalyticsウィンドウ関数を実装しています。 要件ご...
- 質問136 Azureイベントハブからインスタントメッセージングデータを受信...
- 質問137 注:この質問は、同じシナリオを提示する一連の質問の一部です。
- 質問138 Azure SynapseAnalytics専用のSQLプールでデータウェアハウスの...
- 質問139 SQLServerからAzureData LakeStorageに毎日のインベントリデータ...
- 質問140 Azure Databrickクラスターのアプリケーションメトリック、スト...
- 質問141 大きなファクトテーブルを含むAzureSynapseAnalytics専用のSQLプ...
- 質問142 500台の車両の監視ソリューションを設計しています。各車両には...
- 質問143 温度という名前のApacheSparkDataFrameがあります。データのサン...
- 質問144 Azureデータファクトリがあります。 過去60日間のパイプライン障...
- 質問145 Azure Data Lake StorageGen2アカウントを作成する予定です 次の...
- 質問146 3番目の正規形スキーマを使用するMicrosoftSQLServerデータベー...
- 質問147 注:この質問は、同じシナリオを提示する一連の質問の一部です。
- 質問148 注:この質問は、同じシナリオを提示する一連の質問の一部です。
- 質問149 注:この質問は、同じシナリオを提示する一連の質問の一部です。
