- ホーム
- Microsoft
- DP-100J - Designing and Implementing a Data Science Solution on Azure (DP-100日本語版)
- Microsoft.DP-100J.v2026-09-25.q259
- 質問83
有効的なDP-100J問題集はJPNTest.com提供され、DP-100J試験に合格することに役に立ちます!JPNTest.comは今最新DP-100J試験問題集を提供します。JPNTest.com DP-100J試験問題集はもう更新されました。ここでDP-100J問題集のテストエンジンを手に入れます。
DP-100J問題集最新版のアクセス
「528問、30% ディスカウント、特別な割引コード:JPNshiken」
以前に、CSV ファイルのフォルダーに基づく training-dataset という表形式のデータセットを使用してトレーニングされたモデルをデプロイしました。
時間の経過とともに、モデルによって生成された特徴量と予測ラベルが、各月のCSVファイルを含むフォルダーに収集されました。推論データを含むフォルダーに基づいて、2つの表形式のデータセットを作成しました。1つは予測ラベルを含むトレーニングデータと完全に一致するスキーマを持つ予測データセット、もう1つは特徴量列と、ファイル名に基づく日、月、年を含むタイムスタンプ列を含むスキーマを持つ特徴データセットです。
モデルのトレーニング以降の特徴データの変化傾向を特定するには、データドリフトモニターを作成する必要があります。そのためには、データドリフトモニターに必要なデータセットを定義する必要があります。
データドリフトモニターを構成するには、どのデータセットを使用すればよいでしょうか?適切なデータセットを適切なデータドリフトモニターのオプションにドラッグしてください。各ソースは、1回使用することも、複数回使用することも、まったく使用しないこともできます。コンテンツを表示するには、ペイン間の分割バーをドラッグするか、スクロールする必要がある場合があります。
注意: 正しい選択ごとに 1 ポイントが付与されます。

時間の経過とともに、モデルによって生成された特徴量と予測ラベルが、各月のCSVファイルを含むフォルダーに収集されました。推論データを含むフォルダーに基づいて、2つの表形式のデータセットを作成しました。1つは予測ラベルを含むトレーニングデータと完全に一致するスキーマを持つ予測データセット、もう1つは特徴量列と、ファイル名に基づく日、月、年を含むタイムスタンプ列を含むスキーマを持つ特徴データセットです。
モデルのトレーニング以降の特徴データの変化傾向を特定するには、データドリフトモニターを作成する必要があります。そのためには、データドリフトモニターに必要なデータセットを定義する必要があります。
データドリフトモニターを構成するには、どのデータセットを使用すればよいでしょうか?適切なデータセットを適切なデータドリフトモニターのオプションにドラッグしてください。各ソースは、1回使用することも、複数回使用することも、まったく使用しないこともできます。コンテンツを表示するには、ペイン間の分割バーをドラッグするか、スクロールする必要がある場合があります。
注意: 正しい選択ごとに 1 ポイントが付与されます。
正解:

Explanation:
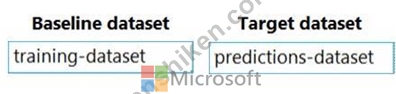
Box 1: training-dataset
Baseline dataset - usually the training dataset for a model.
Box 2: predictions-dataset
Target dataset - usually model input data - is compared over time to your baseline dataset. This comparison means that your target dataset must have a timestamp column specified.
The monitor will compare the baseline and target datasets.
Reference:
https://docs.microsoft.com/en-us/azure/machine-learning/how-to-monitor-datasets

- 質問一覧「259問」
- 質問1 Workspace1 という名前の Azure Machine Learning ワークスペー...
- 質問2 Azure Machine Learning 実験として Python スクリプトを実行す...
- 質問3 Azure Machine Learning のリモート コンピューティングでトレー...
- 質問4 Azure Machine Learning ワークスペースがあります。 ワークスペ...
- 質問5 様々な都市における住宅所有に関する人口統計データを調査する予
- 質問6 Azure Machine Learningワークスペースを作成します。ワークスペ...
- 質問7 Azure Machine Learning ワークスペースに保存されているデータ...
- 質問8 Azure Machine Learning ワークスペースを管理します。開発環境...
- 質問9 Azure Machine Learning デザイナーを使用してトレーニング パイ...
- 質問10 注:この質問は、同じシナリオを提示する一連の質問の一部です。
- 質問11 Azure Machine Learning を使用してハイパーパラメータのチュー...
- 質問12 Python SDK v2 を使用して Azure Machine Learning ソリューショ...
- 質問13 GPUベースのトレーニングを使用して、Azure Machine Learningサ...
- 質問14 バイナリ分類を実行するためにリカレント ニューラル ネットワー...
- 質問15 特徴抽出方法を選択する必要があります。 どちらの方法を使用す
- 質問16 画像分類用のディープラーニング畳み込みニューラルネットワーク
- 質問17 Azure Machine Learning ワークスペースを作成します。 ワークス...
- 質問18 注:この質問は、同じシナリオを提示する一連の質問の一部です。
- 質問19 デザイナーでパイプラインを作成し、自動車価格を予測するモデル
- 質問20 注:この質問は、同じシナリオを提示する一連の質問の一部です。
- 質問21 Azure Machine Learning モデルを作成し、モデルファイルとスク...
- 質問22 Workspace1 という名前の Azure Machine Learning ワークスペー...
- 質問23 トレーニング クラスターと推論クラスターを含む Azure Machine ...
- 質問24 Azure Machine Learning ワークスペースがあります。 Azure Mach...
- 質問25 Azure Machine Learning ワークスペースがあります。ディープ ラ...
- 質問26 Azure Machine Learning ワークスペースのノートブックから df ...
- 質問27 Azure AI Foundry プロジェクトがあります。RAG ソリューション...
- 質問28 Azure Machine Learning ワークスペースを管理します。 MLflow ...
- 質問29 Azure Machine Learning ワークスペースがあり、スイープジョブ...
- 質問30 パフォーマンスカーブの図に示されているように、広告応答モデル
- 質問31 Azure OpenAI サービスの基本モデルをデプロイしました。このモ...
- 質問32 機械学習プロジェクトのデータ処理戦略を設計します。 処理する
- 質問33 Azure Machine Learning ワークスペースを管理します。 Mlftow ...
- 質問34 Azure Machine Learning ワークスペースを作成します。 プライベ...
- 質問35 Azure Machine Learning Python SDK v2 を使用して自動機械学習...
- 質問36 注: この問題は、同じシナリオを提示する一連の問題の一部です。...
- 質問37 注: この問題は、同じシナリオを提示する一連の問題の一部です。...
- 質問38 Git リポジトリを使用して、Azure Machine Learning ワークスペ...
- 質問39 Azure Machine Learning サービスで機械学習モデルをトレーニン...
- 質問40 Azure Machine Learning ワークスペースを作成します。Azure Mac...
- 質問41 モデルのトレーニング時に選択されたハイパーパラメータを最適化
- 質問42 Azure Machine Learning ワークスペースを管理します。コンピュ...
- 質問43 注: この質問は、同じシナリオを示す一連の質問の一部です。この...
- 質問44 チームデータサイエンス環境の構築を計画しています。機械学習パ
- 質問45 Azure Machine Learning ワークスペースを管理します。 構造化さ...
- 質問46 Azure Machine Learningワークスペースを管理しています。モデル...
- 質問47 TensorFlow を使用してディープラーニング モデルを開発していま...
- 質問48 Azure Al Foundry プロジェクトを管理します。 大規模言語モデル...
- 質問49 次の Azure サブスクリプションと Azure Machine Learning サー...
- 質問50 Azure Machine Learning Designer を使用して、次のデータセット...
- 質問51 注:この質問は、同じシナリオを提示する一連の質問の一部です。
- 質問52 Azure Machine Learning ワークスペースがあります。 ワークスペ...
- 質問53 ビジネス アプリケーションで使用されるバッチ推論パイプライン
- 質問54 Azure Machine Learningを使用して、dataset1という名前のデータ...
- 質問55 あなたは線形回帰モデルを作成するデータ サイエンティストです
- 質問56 Azure Machine Learning で自動化された機械学習を使用して、マ...
- 質問57 Azure Ai Foundry ポータルを使用して、Azure OpenAI サービス ...
- 質問58 ローカル ワークステーションで Azure Machine Learning Python ...
- 質問59 注:この質問は、同じシナリオを提示する一連の質問の一部です。
- 質問60 注:この質問は、同じシナリオを提示する一連の質問の一部です。
- 質問61 Azure Notebooks で train-classification という名前の Azure M...
- 質問62 決定木アルゴリズムを使用して分類モデルをトレーニングします。
- 質問63 一連のCSVファイルには売上記録が含まれています。すべてのCSVフ...
- 質問64 デザイナを使用して、分類モデルのトレーニングパイプラインを作
- 質問65 差分プライバシーを使用して、レポートが非公開であることを確認
- 質問66 Azure Machine Learning Studioで新しい実験を作成しています。...
- 質問67 Azure Machine Learning ワークスペースに複数の機械学習モデル...
- 質問68 次の形式の salesData という名前の Python データ フレームがあ...
- 質問69 Azure Machine Learningモデルをトレーニングして登録します モ...
- 質問70 Azure Machine Learning ワークスペースを管理しています。Azure...
- 質問71 群衆感情モデルの評価戦略を定義する必要があります。 順番に実
- 質問72 Azure Machine Learning ワークスペースを管理しています。scrip...
- 質問73 マルチクラス画像分類ディープラーニング モデルを作成します。 ...
- 質問74 Azure Machine Learning を使用して、Bandit 早期終了ポリシーに...
- 質問75 Azure Machine Learning Designerを使用して、回帰モデルのトレ...
- 質問76 注:この質問は、同じシナリオを提示する一連の質問の一部です。
- 質問77 Azure Machine Learning ワークスペースを管理しています。Azure...
- 質問78 Azure Machine Learning ワークスペースを使用します。 トレーニ...
- 質問79 ホテル予約ウェブサイトの不正取引を予測するための機械学習モデ
- 質問80 Azure Machine Learning を使用してモデルをトレーニングおよび...
- 質問81 Azure Machine Learning ワークスペースを使用しています。モデ...
- 質問82 分類タスクに取り組んでいます。ある生徒がサッカーをしたいかど
- 質問83 以前に、CSV ファイルのフォルダーに基づく training-dataset と...
- 質問84 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
- 質問85 Azure Machine Learning ワークスペースを管理しています。この...
- 質問86 コンピューティング クラスターを使用して新しい Azure Machine ...
- 質問87 バイアスと分散の問題に対処するには、グローバル ペナルティ イ...
- 質問88 既存のモデルを再トレーニングします。 モデルの現在のバージョ
- 質問89 PyTorchフレームワークを使用して、多クラス画像分類ディープラ...
- 質問90 Azure Machine Learning ワークスペースを管理しています。scrip...
- 質問91 機械学習モデルを作成しています。 データ内の外れ値を特定する
- 質問92 Azure Machine Learning ワークスペースを管理します。 Python S...
- 質問93 2値分類モデルを作成します。Fairlearnパッケージを使用してモデ...
- 質問94 注: この問題は、同じシナリオを提示する一連の問題の一部です。...
- 質問95 Workspace1 という名前の Azure Machine Learning ワークスペー...
- 質問96 Azure Machine Learning ワークスペースがあります。 ワークスペ...
- 質問97 Python SDK v2を使用して、Azure Machine Learningワークスペー...
- 質問98 Azure Al Foundry プロジェクトのフローを開発します。 フローを...
- 質問99 ペナルティ イベント検出のプロセスを定義する必要があります。 ...
- 質問100 データ サイエンス プロジェクト用に Azure Machine Learning Ba...
- 質問101 Azure Machine Learning ワークスペースを管理しています。ワー...
- 質問102 Azure Machine Learning ワークスペースを管理しています。Azure...
- 質問103 Azure Machine Learning ワークスペースでデータ ラングリングお...
- 質問104 Azure Machine Learning Python SDK を使用して、モデルをトレー...
- 質問105 Azureを使用して機械学習の実験を開発しています。次の画像は、...
- 質問106 Azure Machine Learning を使用して、モデルをリアルタイム Web ...
- 質問107 次の Azure サブスクリプションと Azure Machine Learning サー...
- 質問108 自動機械学習を使用して回帰モデルをトレーニングする予定です。
- 質問109 データの視覚化要件に従って、診断テスト評価のための視覚化を作
- 質問110 Azure Machine Learning ソリューションを設計しています。 モデ...
- 質問111 Azure Machine Learning ワークスペースでモデルをトレーニング...
- 質問112 ビジネスとデータの要件を満たす環境を選択する必要があります。
- 質問113 銀行会社向けに、クレジットカード詐欺の可能性のある事例を特定
- 質問114 Python 用の Azure Machine Learning SDK を使用して、次の手順...
- 質問115 Azure Machine Learning Studio を使用してワークスペースを作成...
- 質問116 フィーチャエンジニアリングを行って、さらなる分析のためにデー
- 質問117 Azure Al Foundry プロジェクトと、Azure Blob Storage に保存さ...
- 質問118 Python SDK v2 を使用して Azure Machine Learning ワークスペー...
- 質問119 完成したバイナリ分類機械学習モデルを評価しています。 評価基
- 質問120 ある組織は Azure Machine Learning サービスを使用しており、機...
- 質問121 Sub1という名前のAzureサブスクリプションがあり、その中にAzure...
- 質問122 Azure Machine Learning Studio を使用してバイナリ分類モデルを...
- 質問123 Windows 用のディープ ラーニング仮想マシンを構成します。 次の...
- 質問124 注: この質問は、同じシナリオを示す一連の質問の一部です。この...
- 質問125 MLflowモデルを作成する バッチ推論を行うには、モデルを Azure ...
- 質問126 Azure Machine Learning スタジオを使用して、column1 という名...
- 質問127 あなたは、鳥類の健康と渡りを追跡するプロジェクトのリードデー
- 質問128 「workspaces」という名前の Azure Machine Learning ワークスペ...
- 質問129 AmICompute クラスターとバッチ エンドポイントを含む Azure Mac...
- 質問130 Azure Machine Learning ワークスペースを使用します。 エンドポ...
- 質問131 Azure Machine Learning Python SDK v2 のハイパーパラメータ調...
- 質問132 Azure Machine Learning でトレーニング実験を実行する Python ...
- 質問133 Azure Machine Learning デザイナーを使用して、すべての国の国...
- 質問134 Azure Machine Learning ワークスペースを管理します。Azure Mac...
- 質問135 注:この質問は、同じシナリオを提示する一連の質問の一部です。
- 質問136 Azure Machine Learning ワークスペースを管理しています。ノー...
- 質問137 測定値からペンギンの種を予測できる機械学習モデルを作成してい
- 質問138 同僚が次のコードを使用して、機械学習サービス ワークスペース
- 質問139 Azure Machine Learning Studio で分類タスクを実行しています。...
- 質問140 注: この質問は、同じシナリオを提示する一連の質問の一部です。...
- 質問141 コンピューティングインスタンス「compute1」を持つAzure Machin...
- 質問142 Azure Machine Learning Studioの時系列データセットを使用して...
- 質問143 (Exhibit) ワークスペース内のデータや実験を操作するには、Azur...
- 質問144 株価を予測する機械学習モデルを実装しています。 このモデルは ...
- 質問145 Azure Machine Learning Studio を使用して、column1 という小数...
- 質問146 Azure Machine Learning を使用して、トレーニング済みおよびデ...
- 質問147 注:この質問は、同じシナリオを提示する一連の質問の一部です。
- 質問148 ローカルの機械学習パイプラインのパフォーマンスの問題を解決す
- 質問149 2クラスのロジスティック回帰モデルを使用して、バイナリ分類を
- 質問150 Azure Al Foundry でモデル ベンチマークを確認しました。 最も...
- 質問151 イベント中の通話数を推定するための回帰モデルを構築しています
- 質問152 データセットに対してフィーチャエンジニアリングを実行していま
- 質問153 テスト要件に応じてデータを分割する方法を特定する必要がありま
- 質問154 Azure Machine Learning Designerを使用して、トレーニングパイ...
- 質問155 ワークスペースという名前のAzure Machine Learningワークスペー...
- 質問156 Azure Machine Learning ワークスペースを管理します。 ハイパー...
- 質問157 Azure Machine Learning ワークスペースから実行される実験を取...
- 質問158 大規模な糖尿病患者グループの年齢情報を含むデータセットを分析
- 質問159 Azure OpenAI サービス ベース モデルがデプロイされています。 ...
- 質問160 CSVファイルからテキストを前処理する予定です。Azure Machine L...
- 質問161 Azure Container Instances にモデルをデプロイします。 モデル ...
- 質問162 Azure Machine Learningワークスペースがある Azure Machine Lea...
- 質問163 決定木アルゴリズムを使用しています。木の深さが10で適切に一般...
- 質問164 ペナルティ イベント検出のプロセスを定義する必要があります。 ...
- 質問165 一連のデータサイエンス実験のために、ビルド済みの開発環境を選
- 質問166 Azure Machine Learning サービスを使用して、training.data と...
- 質問167 機密データを含むデータセットがあります a。データセットを使用...
- 質問168 Azure Machine Learning Studio で多重線形回帰モデルを作成して...
- 質問169 Azure OpenAI サービス モデルが接続された Azure AI Foundry プ...
- 質問170 Azure Machine Learning ワークスペースを作成します。 ワークス...
- 質問171 Azure Machine Learning Studioを使用して、バイナリ分類モデル...
- 質問172 注: この質問は、同じシナリオを示す一連の質問の一部です。この...
- 質問173 Azure ストレージ アカウント内の BLOB コンテナーを参照する tr...
- 質問174 Azure Machine Learning ワークスペースがあります。 モデルをト...
- 質問175 Azure Al Foundryプロジェクトを管理します Azure Al Foundry SD...
- 質問176 新しいAzureサブスクリプションを作成します。サブスクリプショ...
- 質問177 Workspace 1 Workspace! という名前の Azure Machine Learning ...
- 質問178 近くの気象観測所からデータを収集しています。weather_df とい...
- 質問179 Azure Machine Learningワークスペースを作成します ワークスペ...
- 質問180 Azure Machine Learning Python SDK を使用して、バッチ推論パイ...
- 質問181 Azure Machine Learning ワークスペースを作成し、MLflow ライブ...
- 質問182 Azure Machine Learning ワークスペースを使用します。Azure Dat...
- 質問183 Azure Machine Learning を使用して機械学習モデルをトレーニン...
- 質問184 Azure Machine Learning のトレーニング実験を実行します。トレ...
- 質問185 注: この問題は、同じシナリオを提示する一連の問題の一部です。...
- 質問186 「workspaces」という名前のAzure Machine Learningワークスペー...
- 質問187 注:この質問は、同じシナリオを提示する一連の質問の一部です。
- 質問188 Azure Machine Learning Studioを使用してデータセットを分析し...
- 質問189 Azure Al Foundry プロジェクトを管理します。 2 つの RAG ソリ...
- 質問190 Azure Machine Learning Studio を使用して、コンピューティング...
- 質問191 グローバル ペナルティ検出モデルのサンプリング戦略を構築する
- 質問192 Azure CLI ml拡張機能v2を使用してAzure Machine Learningワーク...
- 質問193 Azure Machine Learning を使用してモデルをトレーニングします...
- 質問194 WS1 という名前の Azure Machine Learning ワークスペースがあり...
- 質問195 Azure Machine Learning ワークスペースを管理します。 ジョブの...
- 質問196 分類タスクを解決しています。 データセットのバランスが崩れて
- 質問197 モデル開発戦略を実装して、ユーザーが広告に反応する傾向を判断
- 質問198 分類タスクを解決しています。 k分割交差検証を使用して、限られ...
- 質問199 Azure Machine Learning ソリューションの実装を計画しています...
- 質問200 英語のテキストコンテンツをフランス語のテキストコンテンツに翻
- 質問201 ワークスペースという名前のAzure Machine Learningワークスペー...
- 質問202 Azure Machine Learning ワークスペースを作成します。 次の要件...
- 質問203 Projectsという名前のAzure Al Foundryプロジェクトがあります ...
- 質問204 Azure Machine Learning の Hyperdrive 機能を使用してモデルを...
- 質問205 Azure MachineLearningワークスペースでモデルを作成して登録し...
- 質問206 注: この問題は、同じシナリオを提示する一連の問題の一部です。...
- 質問207 地元のタクシー会社の履歴データを含むデータセットを分析し、回
- 質問208 注:この質問は、同じシナリオを提示する一連の質問の一部です。
- 質問209 Azure Machine Learning を使用して機械学習モデルを作成します...
- 質問210 Azure Al Foundry プロジェクトを管理します。 推論と問題解決を...
- 質問211 注:この質問は、同じシナリオを提示する一連の質問の一部です。
- 質問212 computet という名前のコンピューティング インスタンスを使用し...
- 質問213 Azure Machine Learning ワークスペースを管理しています。 ニュ...
- 質問214 二値分類を実行するためのリカレントニューラルネットワークを構
- 質問215 Spark プールを使用して、Azure Machine Learning ワークスペー...
- 質問216 K-meansアルゴリズムを使用してクラスタリングを実行しています...
- 質問217 Azure Al Foundryプロジェクトを管理し、ベースモデルを微調整し...
- 質問218 Workspace1 という名前の Azure Machine Learning ワークスペー...
- 質問219 Azure Machine Learning ワークスペースがあり、ローカルコンピ...
- 質問220 機械学習モデルが、敏感な特徴にわたって不公平な予測を生成する
- 質問221 提供されたトレーニング セットを使用してバイナリ分類モデルを
- 質問222 注:この質問は、同じシナリオを提示する一連の質問の一部です。
- 質問223 Workspace1 という名前の Azure Machine Learning ワークスペー...
- 質問224 Azure Machine Learning ワークスペースを管理しています。ワー...
- 質問225 注:この質問は、同じシナリオを提示する一連の質問の一部です。
- 質問226 注: この問題は、同じシナリオを提示する一連の問題の一部です。...
- 質問227 注:この質問は、同じシナリオを提示する一連の質問の一部です。
- 質問228 自動化された機械学習を使用して、分類モデルと回帰モデルをトレ
- 質問229 woricspace1 という名前の Azure Machine Learning ワークスペー...
- 質問230 Azure At Foundry プロジェクトを管理します。 RAGソリューショ...
- 質問231 Azure Al Foundry プロジェクトを管理します。 モデル カタログ...
- 質問232 Azure Machine Learning Studio で実験を作成し、10,000 行のト...
- 質問233 Azure Machine Learning ワークスペースを管理しています。scrip...
- 質問234 注:この質問は、同じシナリオを提示する一連の質問の一部です。
- 質問235 添付資料 A で指定された順序で処理する必要がある 5 つの Pytho...
- 質問236 Azure AI Foundry プロジェクトがあります。RAG ソリューション...
- 質問237 TSV ファイルのセットを含む Azure BLOB コンテナーがあります。...
- 質問238 テスト要件に応じてデータを分割する方法を特定する必要がありま
- 質問239 Azure Machine Learningモデルをトレーニングして登録します モ...
- 質問240 バイナリ分類モデルを作成します。 モデルのパフォーマンスを評
- 質問241 Azure Machine Learning SDK を使用して、分類モデルをトレーニ...
- 質問242 Azure Machine Learning ワークスペースがあります。ワークスペ...
- 質問243 トラフィックの最適化のための Azure Machine Learning ソリュー...
- 質問244 注:この質問は、同じシナリオを提示する一連の質問の一部です。
- 質問245 ノートブックからAzure ML Python SDK v2ベースのモデルをトレー...
- 質問246 Azure Machine Learning ワークスペースを作成します。 ワークス...
- 質問247 機械学習モデルをトレーニングして登録します。モデルを使用して
- 質問248 Azure Machine Learning を使用して機械学習モデルをトレーニン...
- 質問249 注:この質問は、同じシナリオを提示する一連の質問の一部です。
- 質問250 注: この問題は、同じシナリオを提示する一連の問題の一部です。...
- 質問251 Azure Machine Learning ワークスペースがあります。 Azure Mach...
- 質問252 モデルをトレーニングするときに、Azure Machine Learning の Hy...
- 質問253 Azure MachineLearningで実験としてスクリプトを実行します。 実...
- 質問254 短い文章形式で記述された12,000件の顧客レビューを含むCSVファ...
- 質問255 Azure Machine Learning を使用して、Azure ML Python SDK v2 ベ...
- 質問256 ローカル モデルの特徴抽出戦略を構築する必要があります。 コー...
- 質問257 Azure Machine Learning ワークスペースを作成します。Azure Mac...
- 質問258 Azure Machine Learning デザイナーを使用して実験を構築してい...
- 質問259 Azure Machine Learning ワークスペースを管理します。 Python S...
